安全倫理
偏好非安全:成對偏好評估對臨床安全的指標效力有限
Preferred, Not Safer: Pairwise Preference Is a Poor Proxy for Clinical Safety

arXiv cs.CL2026-08-05
摘要
一項針對 26,804 個成對判斷的研究發現,臨床醫生的偏好評估並非臨床安全的可靠指標。研究通過 MOOVE 平台收集超過 736 位來自 28 個國家的臨床醫生的盲測評估,發現在成對偏好中排名高的 LLM 模型仍可能在「無害性」和「準確性」等關鍵安全維度出現大量臨床失敗,且這些風險在不同醫療專科間分布不均勻。
一項基於 arXiv cs.CL 的研究針對 26,804 個成對判斷進行評估,旨在檢驗臨床醫生的成對偏好是否能作為大型語言模型(LLM)臨床安全的可靠指標。該研究利用 MOOVE(Massive Open Online Validation and Evaluation)平台,收集了來自 28 個國家超過 736 位臨床醫生的盲測評估數據,這些數據包含對 13 個 LLM 輸出結果的成對偏好評分。
在評估機制上,臨床醫生使用離散分數 $[-2, +2]$ 進行評分,其中負數代表臨床不安全或具誤導性的內容。研究結果顯示,臨床醫生的偏好並非臨床關鍵安全表現的可靠代理指標。即便在成對偏好中排名較高的 LLM 模型,仍可能在「無害性」(Harmlessness)和「準確性」(Accuracy)等關鍵安全維度上出現大量具有臨床意義的失敗(分數 $\leq -1$)。
此外,這些臨床失敗在不同醫療專科之間的分布並不均勻,導致特定領域出現「禁區」(no-go zones)。這表明僅依賴成對偏好評估無法有效識別模型在特定醫療領域中的潛在風險,高排名模型仍可能對特定專科造成實質性的臨床危害。
●開發者:評估 LLM 醫療安全時應採用多維度評分而非單純偏好比較
●投資人:醫療 AI 產品需投入更嚴格的多層級安全驗證機制
●一般用戶:醫療 AI 工具選擇時需警覺表面評分可能隱藏真實風險
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南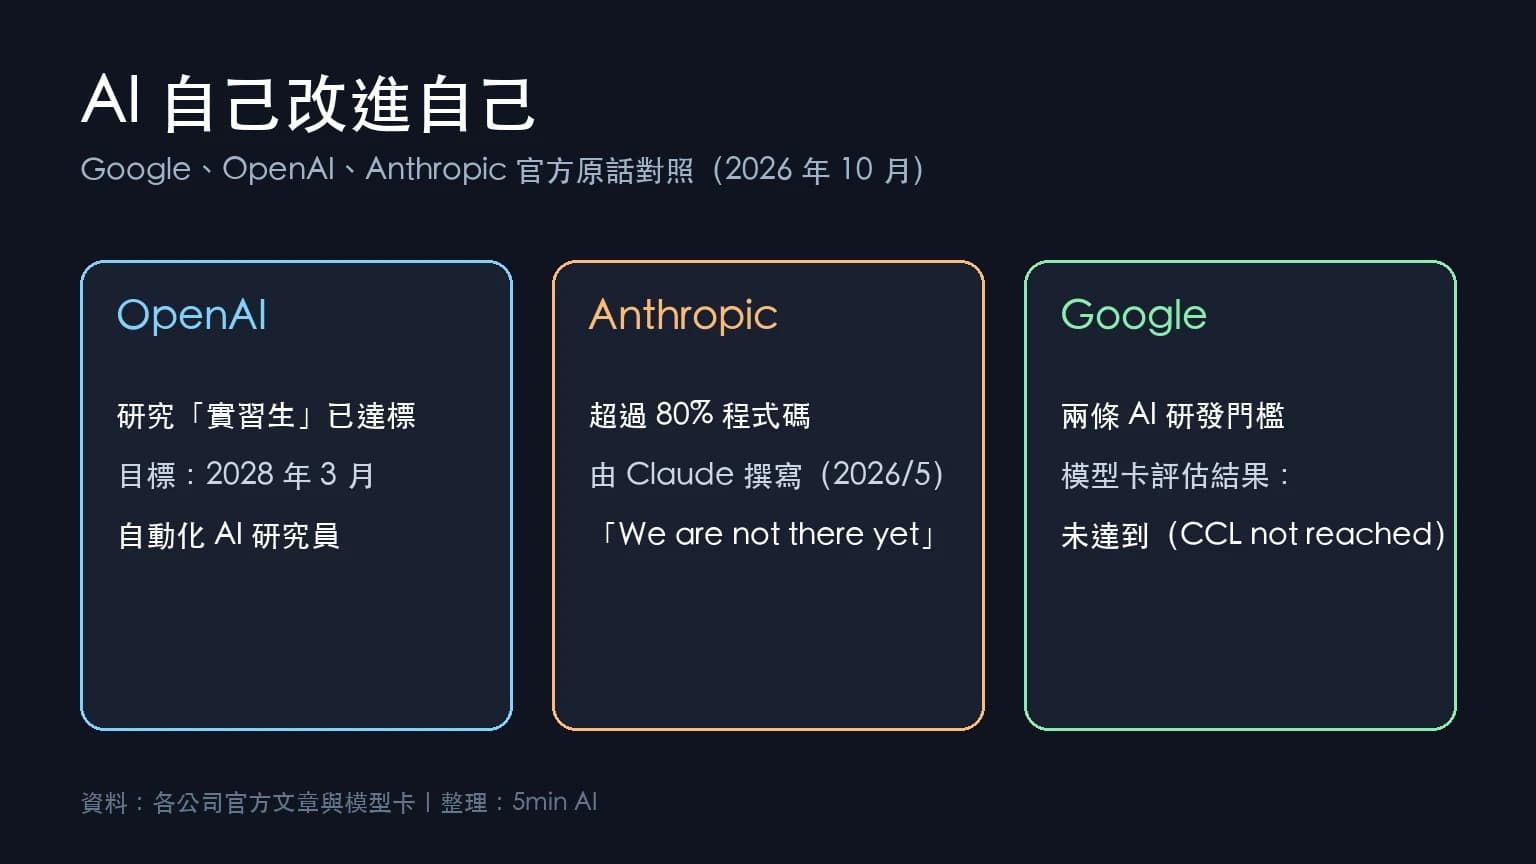
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。