研究突破
參差不齐的評判者:LLM 評委在沉默、壓力和持續質疑下的認知穩定性研究
Jagged Judges: Epistemic Stability Under Silence, Pressure, and Persistence
arXiv cs.AI · 2026-08-14
摘要
研究團隊開發了 Wiggle Framework,用來測試大語言模型作為評判者的認知穩定性。研究發現,9 個最先進的模型在評判安全性、毒性、AI 寫作檢測等任務時,都出現了顯著的「搖晃」現象——在靜態質疑下翻轉評判結果 25-71%,在對抗性壓力下更高達 62-91%。這揭示了當前 LLM 評委作為評估和獎勵建模基礎設施存在的嚴重穩定性問題。
●開發者:需要認真檢視現有基於 LLM 評委的評估流程,考慮多層驗證機制
●投資人:LLM 評估基礎設施的可靠性問題可能影響模型商業化的信任度
●一般用戶:AI 安全評估和內容審核的可靠性需要提高
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
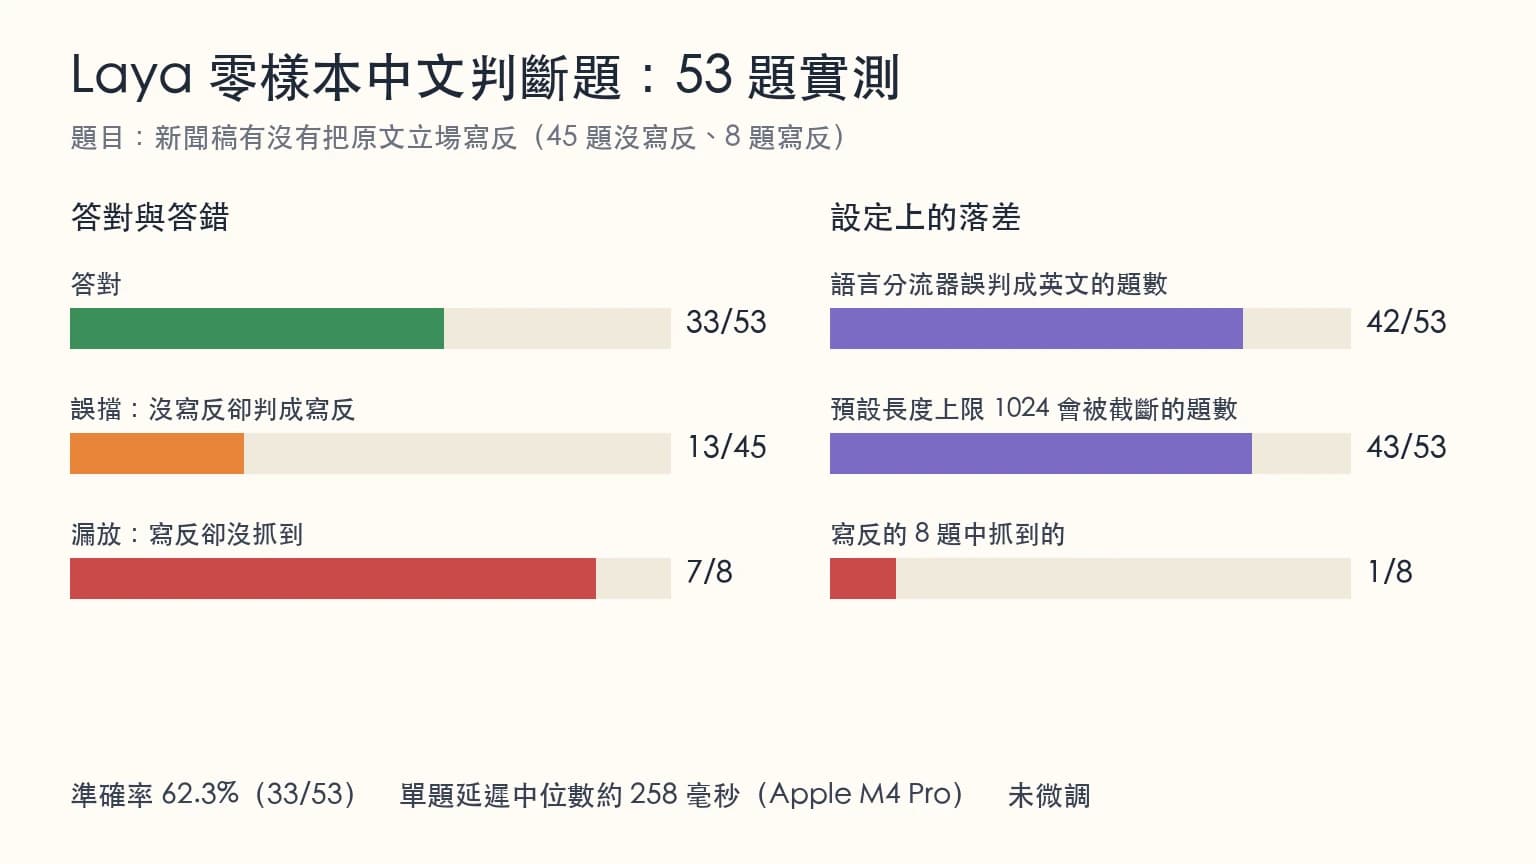
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →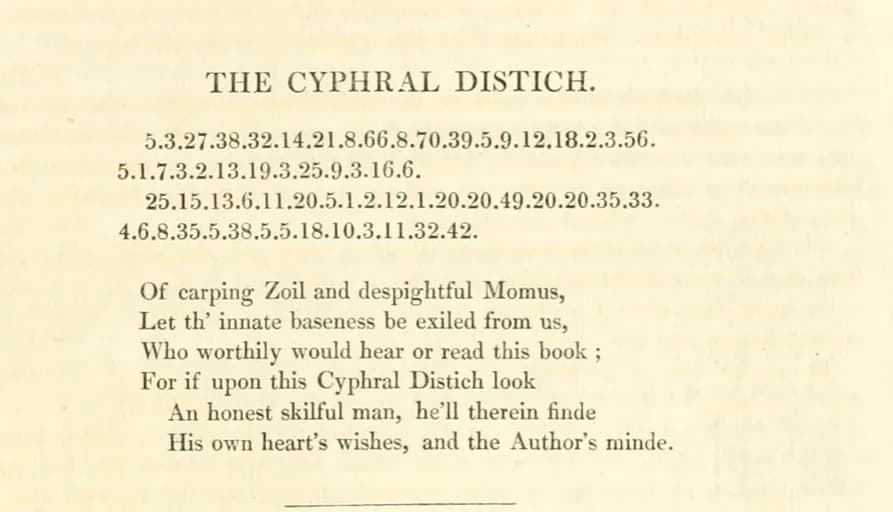
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。