研究突破
從 BERT 到 Frontier Agents:八年的語言模型進展、成本曲線崩塌與任務導向模型的興起
From BERT to Frontier Agents: Eight Years of Language-Model Progress, the Collapse of the Capability-Cost Curve, and the Rise of Task-Targeted Models
arXiv cs.LG · 2026-08-17
摘要
過去八年 AI 模型從 BERT 進化到能解決複雜數學和軟體開發的智慧體,程式碼解決能力自 2024 年末以來每年成長近六倍。成本大幅下降,OpenAI 的 GPT-5.6 Luna 以每百萬 tokens 1-6 美元的價格達到旗艦級能力,而高性能已分散到專門模型,如 Claude Opus 5 領導前端編碼、Claude Fable 5 擅長倉庫級編碼、GPT-5.6 Sol 主導終端任務。
過去八年間,AI 模型經歷了從 BERT 這類簡單系統到複雜智慧體的演進。根據 arXiv 論文,在 2018 年 10 月至 2026 年 7 月期間,這些智慧體已能夠解決複雜數學問題並編寫軟體。
代碼能力的改進速度顯著加快。自 2024 年末以來,解決實際編碼問題的能力每年提升近六倍。
成本結構發生了根本轉變。OpenAI 的預算型模型 GPT 5.6 Luna 以每百萬 tokens 1-6 美元的價格實現了旗艦級性能,超越了舊版本同時大幅降低成本。
高性能能力已經分散到專門化的模型中。Claude Opus 5 在前端編碼領域領先,Claude Fable 5 在儲存庫級編碼中表現優異,GPT 5.6 Sol 則在終端任務中佔優勢。
在數學問題求解能力測試中,使用 Qwen 2.5 模型進行了評估。基礎方法在 100 道小學數學問題中解決了 58 題,而進階採樣方法可達 79 題。此外引入的信心排序工具在其前 50 個選擇中正確識別了 47 個正確答案,證實其在任務分類中的實用價值。
●開發者:應重點評估 Claude Opus 5、Claude Fable 5、GPT-5.6 Sol 等專門模型以優化特定任務,並關注成本優化機會
●投資人:低成本高能力的模型組合商業化趨勢值得關注,任務導向模型分化可能帶來新商機
●一般用戶:編碼輔助和複雜問題解決功能持續改善,成本下降有利於更廣泛應用普及
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →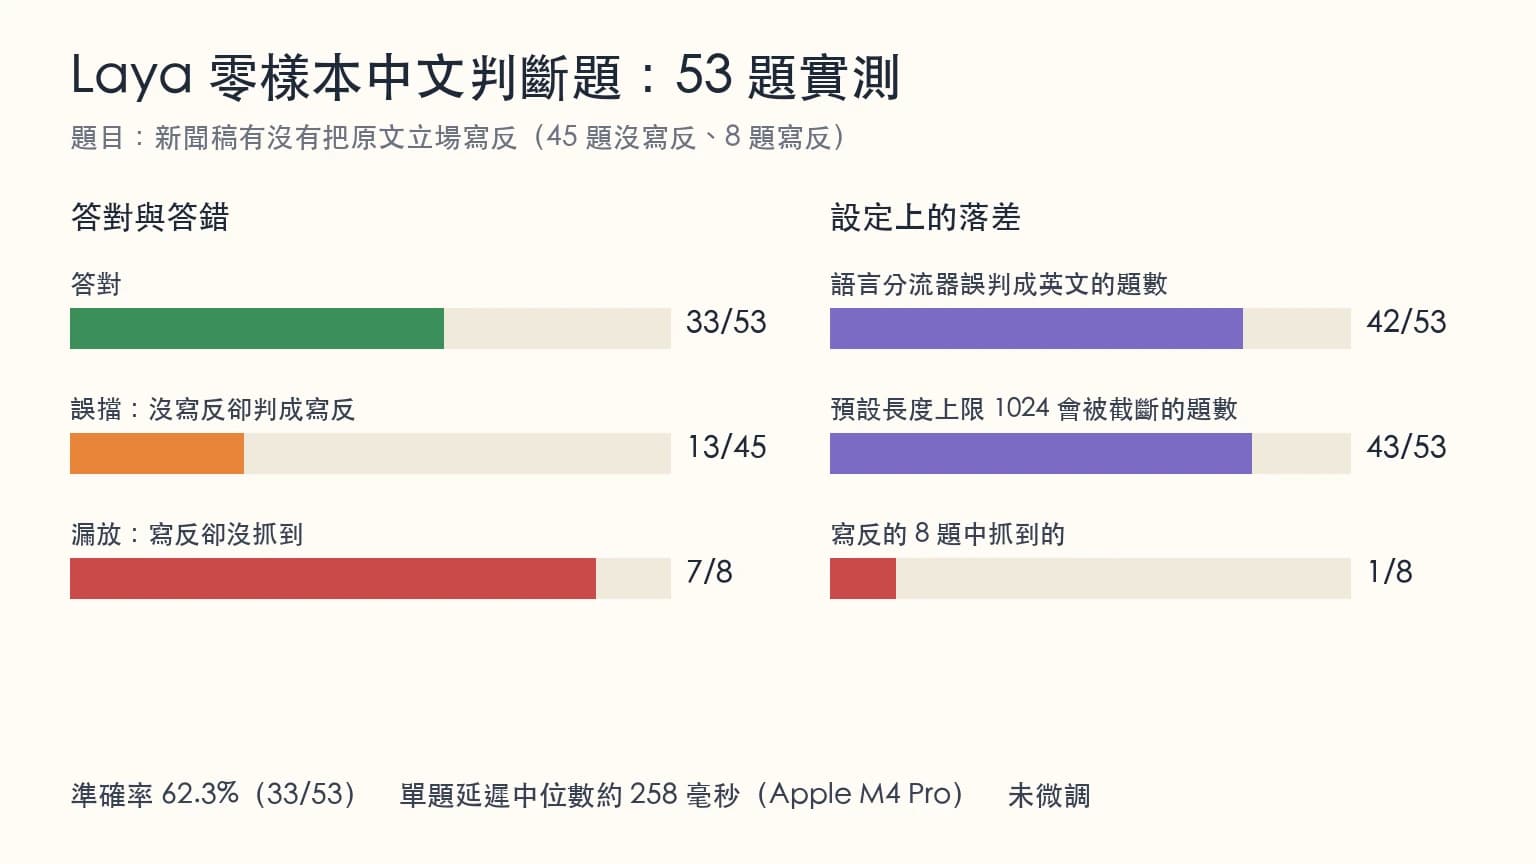
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →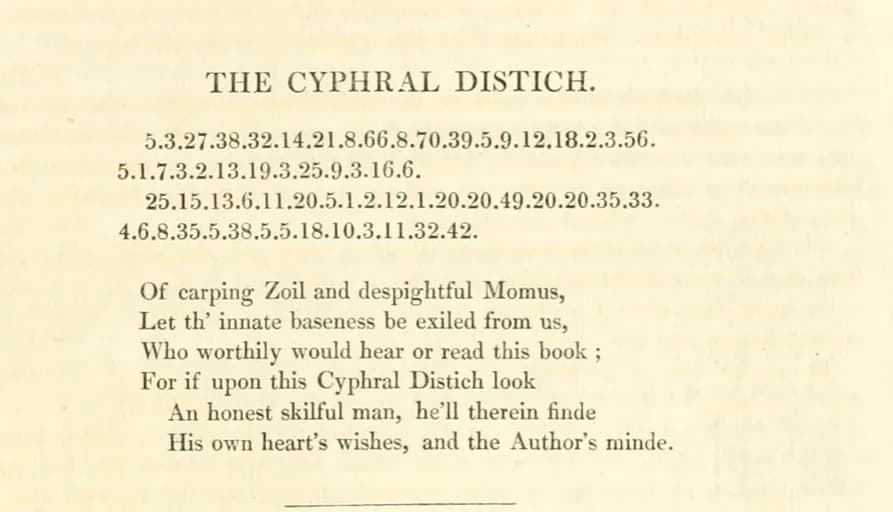
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。