研究突破
為什麼你的本地 LLM 看起來比實際上更笨
Why your local LLM feels dumber than it is
Hacker News · 2026-08-23
摘要
同一組模型權重在本地執行時,會因硬體指令集、推理軟體、注意力後端、權重與 KV cache 的量化精度等實作差異而改變輸出。原文的控制實驗顯示,這些底層差異會造成 token 選擇分歧,低精度 KV cache 甚至可能導致工具呼叫失敗,因此本地結果不能直接等同模型發布方的參考實作。
●開發者:比較模型時需記錄精確的權重、量化方式、KV cache、注意力後端與執行環境
●投資人:本地 AI 部署工具的精度驗證與實作透明度是重要產品能力
●一般用戶:下載同名模型不代表能重現官方品質,量化版本與硬體軟體組合都會影響結果
重要性評分
65/100
🟠 值得關注
本地大型語言模型推理精度模型量化
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

大型語言模型
2026 大型語言模型深度解析:技術架構與應用場景全覽
2026 大型語言模型深度解析:全面探討 LLM 技術原理、AI 模型架構演進及多元 AI 應用場景,為您揭開未來 AI 發展的核心趨勢與實戰策略。
閱讀指南 →
perplexity vs chatgpt
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →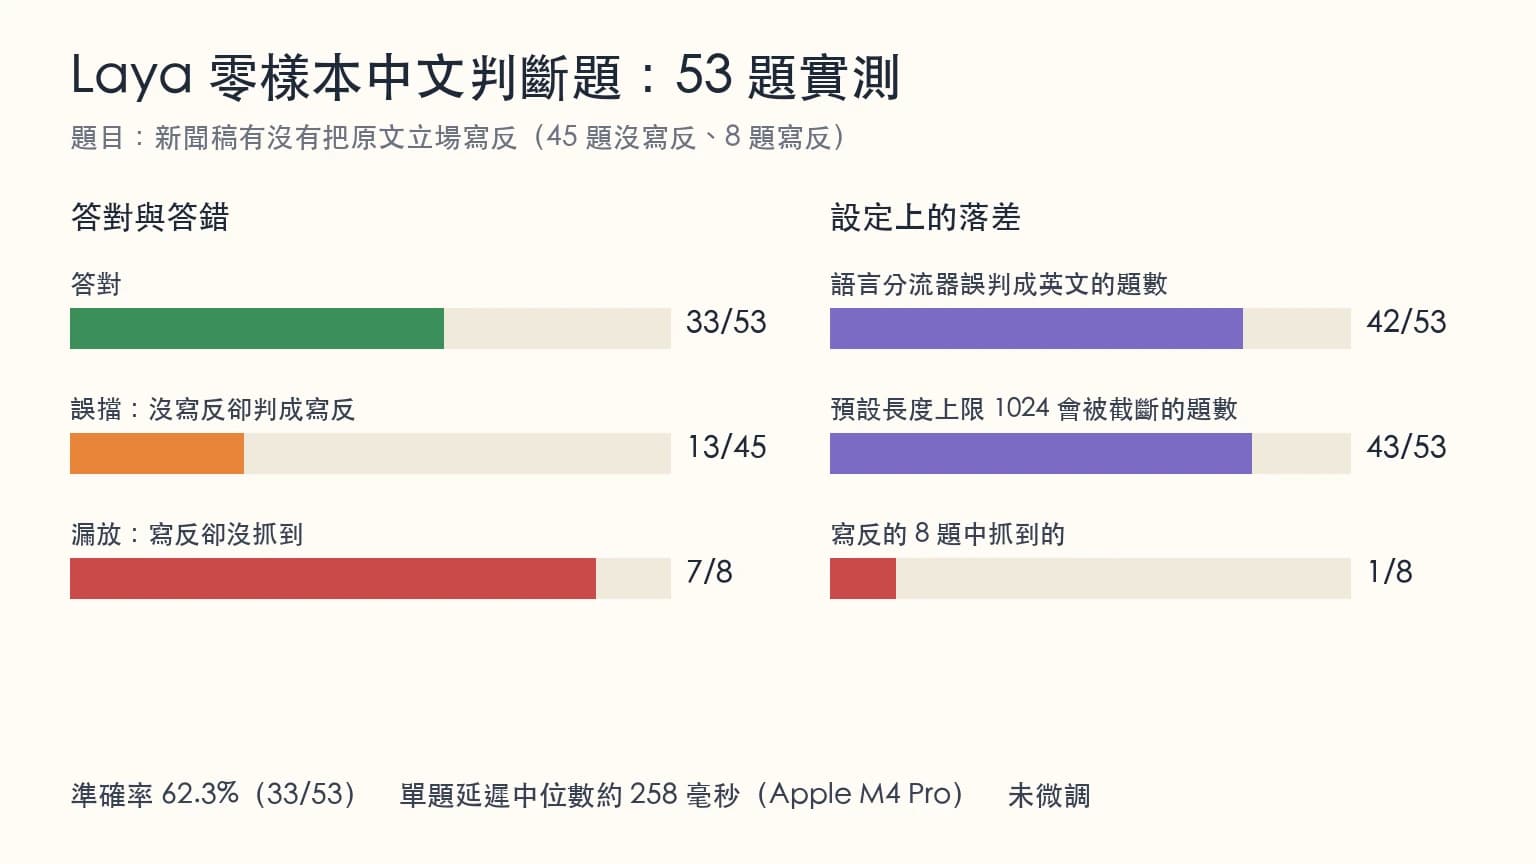
Laya 開源模型
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。