硬體基建
MaxText 成功在 TPU 上復現 OLMo 3 7B 預訓練:大規模訓練的基礎設施突破
Reproducing OLMo 3 7B Pre-training in MaxText: case study of large scale training on TPUs
developers.googleblog.com · 2026-09-26
摘要
Google MaxText 團隊用 JAX/XLA 在雲端 TPU 上從零重建 AI2 的 OLMo 3 7B 模型,精確匹配原始 PyTorch 實現的訓練效果,達到 57.4% 模型浮點利用率。實驗發現了資料載入器的隱藏記憶化漏洞,證明了綜合評估機制的必要性,同時驗證了該基礎設施架構具有良好的可移植性,能承受訓練中途的叢集擴展與 TPU 世代轉換。
Google MaxText 團隊日前宣布在雲端 TPU 上完整重現 AI2(Allen Institute for AI)開發的 OLMo 3 7B 語言模型預訓練過程。這次復現不僅驗證了 JAX/XLA 框架在大規模訓練中的可行性,更揭示了驗證方法論的關鍵價值——一個看似成功的結果背後竟隱藏著難以察覺的資料漏洞。
選擇 OLMo 3 的三項關鍵理由
MaxText 團隊之所以選定 OLMo 3 7B 作為驗證目標,是因為這個模型具備三項罕見共存的特性:它是在真實產業規模訓練的強大現代模型;AI2 公開了幾乎完整的模型流程,包含資料、程式碼、配置、檢查點、日誌和評估結果;同時提供了 PyTorch 與 GPU 的獨立參考實現,可作為 MaxText 和 TPU 的對標基準。
架構轉換與精度驗證
將 OLMo 3 從 PyTorch 轉換至 JAX 是第一個重要重要進展。OLMo 3 採用了三項非標準設計:重新排序的規範化區塊(reordered-norm block)、QK 規範化(QK-norm),以及 3:1 比例的滑動視窗與全域注意力混合。MaxText 團隊在轉換完成後進行了邏輯奇偶校驗,驗證轉換後的第 0 步檢查點與 HuggingFace 參考實現相比,KL 散度約為 1.5e-3,達到了「相同模型、不同框架」的雜訊基線。在完整的 8192 token 上下文與 bfloat16 精度下,兩者在前 1 名 token 選擇上的一致率達 98.75%。
訓練曲線追蹤與資料漏洞發現
在 stage-1 預訓練的約 1.41M 步執行中,MaxText 的損失曲線整體跟蹤了 AI2 的公開曲線。然而,到了約 90 萬步後,MaxText 的訓練損失開始持續低於 AI2,這起初看起來像是性能優勢。但在 125 萬步附近,這個差距擴大到平均 −0.06,有些步驟跨度甚至達到 −0.25。
關鍵發現:驗證工作揭露了真相。
保留評估(held-out evaluation)在相同檢查點處顯示,MaxText 的 C4 損失實際上與 AI2 持平(分別為 −0.004 和 +0.003 的差異),而下游準確度則略微傾向 AI2。這是典型的記憶化特徵——模型在訓練中多次看到相同的序列,因此在重複實例上得到了虛假的低損失。
資料載入器的雙重分片漏洞
問題源於 MaxText OLMo 資料載入器的雙重分片漏洞。該載入器在索引取樣器已經進行內部分片的情況下,又向 Grain DataLoader 傳遞了 ShardOptions。Grain 的 shard_options 不僅記錄中繼資料,還會改變取樣器索引流的步進。當 shard_count=32 時,資料遊標推進速度快了 32 倍,導致 stage-1 從一個完整的訓練 epoch 變成了近似卜瓦松分佈的有放回重取樣:約 37% 的語料庫未曾見過,37% 見過一次,26% 見過兩次或以上。
雖然 token 預算保持不變(約 5.9T 實際 token),但重複實例精確對應了訓練損失下降的位置。這個漏洞直到 MaxText 團隊檢視保留評估時才被發現——單靠訓練損失曲線完全看不出來。
驗證方法論的關鍵教訓
這次發現引出了兩項重要認知:
1. 訓練損失不能作為收斂證明。 唯一防止發布「MaxText 超越參考實現」虛假結論的原因,是團隊承諾在每個重要進展進行保留評估。記憶化導致的損失下降在 C4 保留評估和全部 8 項下游任務上都完全看不見。
2. 誠實的復現需要為 bug 預留預算。 修復(將 Grain 配置改為 NoSharding(),讓取樣器完全掌控分片)只需一行程式碼,但找到它需要一個 A/B 測試框架、一個再現 shard_count>1 時發散的單元測試,以及硬體重新執行來驗證。
檢查點與復現的精確性
驗證過程中發現了第二個獨立漏洞:復現步驟偵測中的偏移一誤。檢查點目錄編號為 N,但訓練迴圈在第 N 次迭代完成後寫入 N 目錄,導致模型恢復到步驟 N+1 時資料載入器仍在批次 N,永久地使後續步驟晚一步執行。修復兩個漏洞後,從檢查點恢復的執行與無間斷執行完全一致:在所有 99 個步驟上記錄的損失差異為 0.000。
在檢查點後 127 步因主機故障中斷後重新執行時,恢復執行的損失完美匹配原始執行:損失和困惑度上的 Δ = 0.000。
Ironwood 上的性能與規模適應
團隊在 Google Cloud TPU Ironwood 上達到 44.5% 的模型浮點利用率(MFU),每個裝置約 510–513 TFLOP/s。性能提升主要來自:
- SparseCore 集體卸載與 XLA 優化:將 all-gather、2D all-gather、reduce-scatter 等集合通訊卸載至 SparseCore,搭配 v7x 特定的 XLA 旗標,從 41% 提升至 44.5% MFU - 擴展重材料化:檢查點化注意力與 MLP 投影層 - Splash 注意力加 Tokamax:使用 2048 token 區塊
叢集擴展中的動態調度能力
JAX/XLA 棧最有用的特性是配方與拓撲解耦。全域批次固定在 512 個實例(4.19M token/步),但分佈的晶片數量完全可變。
在約 105 萬步時,MaxText 失去了四分之三的容量,執行在一個 128 裝置的分片(原規模的四分之一)上恢復,全域批次保持不變。每個裝置的吞吐量保持在 510–513 TFLOP/s/裝置,只有每步的牆鐘時間改變(0.76 秒→3.05 秒,符合預期的 4 倍)。這種能力使長執行能在競爭激烈的叢集上存活,取用所有可用的容量同時保持數學恆定。
Stage 2:中期訓練退火與跨代 TPU 運行
完成 stage-1 匹配後,團隊進行了 stage-2(中期訓練退火)的驗證。Stage-2 在 Dolmino 100B 混合集上對 stage-1 模型進行退火,學習率從 2.0712e-4 線性衰減至 0,共 47,684 步。
更值得注意的是,stage-2 在不同 TPU 世代上運行。原本針對 Ironwood 調優的相同啟動程式碼,改變設備類型後直接指向 TPU v5p(v5p-256,128 晶片),在未進行任何 v5p 特定調優的情況下達到 57.4% MFU(每晶片 263 TFLOP/s),高於 stage-1 的 44.5%,因為 7B 模型更容易飽和 v5p 這款舊款晶片。整個執行期間,每晶片吞吐量的分佈在 263.0 至 263.9 TFLOP/s 之間,在 47,684 步的全程中波動僅 0.4%。
Stage-2 收斂驗證與資料順序噪聲
整個 47,684 步的訓練過程中,相對 AI2 的訓練損失差異為 +0.0044,幾乎完全來自前約 8k 步。這個早期差異並非配方不匹配,而是因為兩個隨機重排在早期訓練了大部分不同的資料:12.2M 實例混合中的兩個隨機 8k 步首碼只共享約 17% 的實例(在 1k 步時僅 2%)。當覆蓋重疊後,差異消失:第 12k 步之後的每個 4k 步視窗都在 +0.0000 至 +0.006 之間,執行後三分之一的平均值為 +0.0007,實質上是平手。
MaxText 在保留 C4 損失、多域困惑度和 8 項 lm-eval 任務套件上都與 AI2 的 stage-2 最終檢查點一致。在三個重要進展上的評估顯示保留損失差異始終保持在 ~+0.006 nat 的平穩水準,MMLU 5-shot 在退火過程中,我方從 0.605 提升至 0.648,AI2 則從 0.605 提升至 0.650,8 項任務宏觀準確度提升約 0.6 個百分點(AI2 為 +0.9)。
多工作者資料迭代器狀態檢查點
Stage-2 暴露了 stage-1 修復未涵蓋的復現漏洞:精確復現僅在 grain_worker_count=1 時有效。Stage-2 執行 4 個工作者(與 AI2 相同),無狀態復現(從步驟推導資料偏移)會發散,因為新啟動的載入器在某個偏移處交錯工作者的記錄方式與未中斷流不同。
MaxText 將 olmo_grain 透過 Grain 的 GrainCheckpointHandler 連接,檢查點現在在模型項目旁邊攜帶迭代器狀態,復現時以原子方式恢復權重、優化器狀態和確切的資料迭代器位置。一個計畫外的驗證在 16 小時後出現:主機故障在第 19,627 步殺死了工作集,執行從第 19,500 檢查點恢復並重新訓練 127 個遺失的步驟。由於這些步驟已在故障前記錄,團隊得到了一個免費的配對差異,重新訓練的損失與原始值完全相同:在所有 127 步上 Δ = 0.000(損失和困惑度),而破損的復現通常會產生 ~0.01–0.4 的離散。更重要的是,這發生在 grain_worker_count=4 的確切配置下,正是無狀態復現失敗的地方。
硬體軟體協設計帶來的免費加速
團隊進行了一項架構消融,意外轉化為硬體軟體協設計的重大勝利。OLMo-3 7B 標準配置為 32 個查詢頭 × 128 維頭寬。由於 num_heads × head_dim = emb_dim = 4096,可以透過改為 16 頭 × 256 維頭寬來交換頭數與寬度。這項架構調整保持了完全相同的 7.298B 參數和 1565 TFLOP/步,但改變了張量形狀以完美對齊底層硬體。
Ironwood 的矩陣乘法單元(MXU)是一個 256×256 的脈動陣列。標準的 head-dim 128 在注意力 QK 矩陣乘法期間使陣列的一半處於閒置。重塑為 head-dim 256 完全對齊了張量維度至 256,完全防止了閒置計算週期,產生 +12.4% 的吞吐量增加(571 對比 508 TFLOP/s/裝置,或 49.6% 對比 44.2% MFU),同時參數和 FLOP 完全相同。
優化器資料型別隱藏陷阱
設定 weight_dtype=bfloat16 默默將 Adam 的動量(m/v moments)透過 mu_dtype 繼承降級,在 1000 步內增加 +0.93 的損失。bfloat16 的約 3 位有效數字會丟失每個微小的早期預熱更新的一部分,並複合累積。保留 weight_dtype=float32(預設值)將差異縮小了 30 倍。這是整個專案中「為什麼它不匹配」的最大驚喜時刻。
計算成本與效率
Stage-1 耗費約 77k Ironwood 晶片小時的步驟計算(約 3,200 晶片天),加上檢查點、評估和重新啟動開銷。由於性能優化工作(主要是 SparseCore 卸載和重材料化),相較於預期的 30% MFU 預算,實現的性能買回了約三分之一的計算量(預計需約 113k 晶片小時)。Stage-2 相對便宜,約 5k v5p 晶片小時。
核心教訓與方法論
這次多周期、跨棧的復現任務傳授了重要的實踐智慧:
- 保留評估在每個重要進展是不可協商的。 單獨的訓練損失會發布假的「我們超越了參考」聲明;資料漏洞在重複實例上降低了訓練損失,但保留損失和準確度從未動搖。
- 將優化器狀態保存為 fp32。 weight_dtype=bfloat16 默默降級了 Adam 的動量,在 1000 步內增加 +0.93 損失;fp32 預設將其縮小 ~30 倍。
- 復現必須精確。 復現步驟偵測中的偏移一誤使資料與參數不同步,在損失曲線上完全看不見;只有配對 A/B 差異能偵測到。
- 將配方與拓撲及硬體世代解耦。 JAX/XLA 讓執行承受 512→128 裝置調整和反覆搶佔,配方無需更改,隨後 stage-2 用相同啟動器在不同 TPU 世代(v5p,57.4% MFU)上執行。在競爭激烈的叢集中至關重要。
- 形狀是免費的槓桿。 重塑頭部(32×128→16×256)在完全相同的參數和 FLOP 下買回 +12.4% 吞吐量(44.2%→49.6% MFU),因為 head-dim 256 填充了 Ironwood 的 256×256 MXU。在提交長執行前值得檢查。
- 注意多工作者陷阱。 jax.device_count() 是本地的:在調整大小時需要透過線程化全域 TOTAL_DEVICES,否則有效批次會默默轉移。給自動復現提供真正的退避(不是硬性 60 秒)以度過長調度隊列。
後續計畫
Stage-1 與 Stage-2 已完成。Stage-3(長上下文適應,使用 YaRN 縮放延伸至 65k 上下文)和後訓練(透過 Tunix 進行 SFT 和 GRPO)是接下來規劃但尚未執行的項目。
MaxText 的完整復現證明,PyTorch-on-GPU 預訓練配方確實可以在 JAX-on-TPU 中忠實復現,但僅當你衡量泛化而非單純訓練損失時。最關鍵的方法論選擇是在每個重要進展進行保留評估驗證——它揭露了偽裝成勝利的資料漏洞,也是能夠直言「復現成功」的原因。
●開發者:掌握 JAX 在大規模預訓練中的最佳實踐與除錯方法
●投資人:Google TPU 基礎設施的實用性與成熟度進一步驗證
●一般用戶:更高效的大型語言模型訓練流程將降低模型開發成本
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
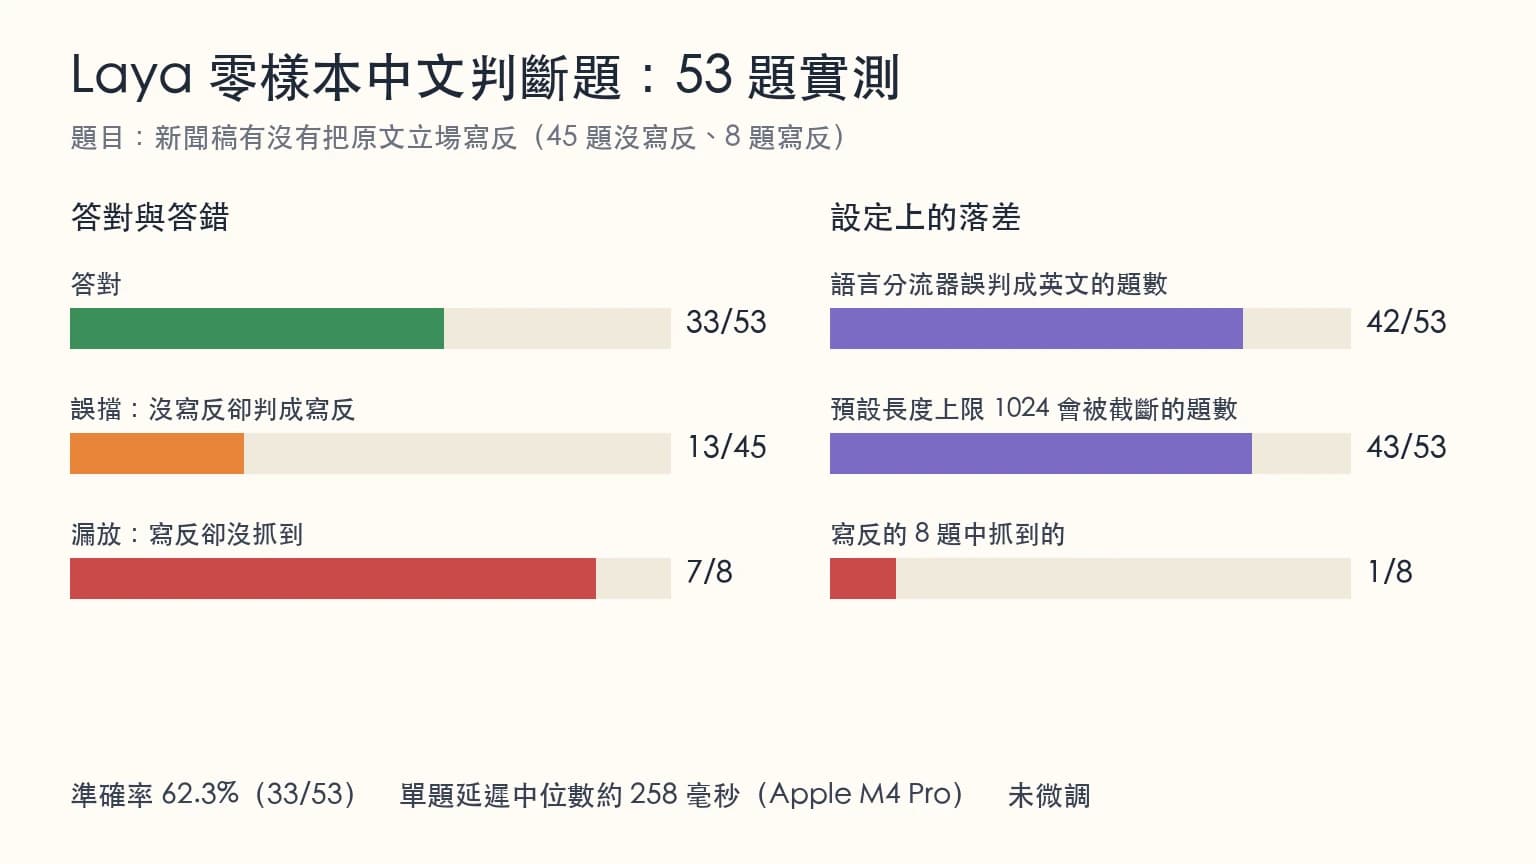
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →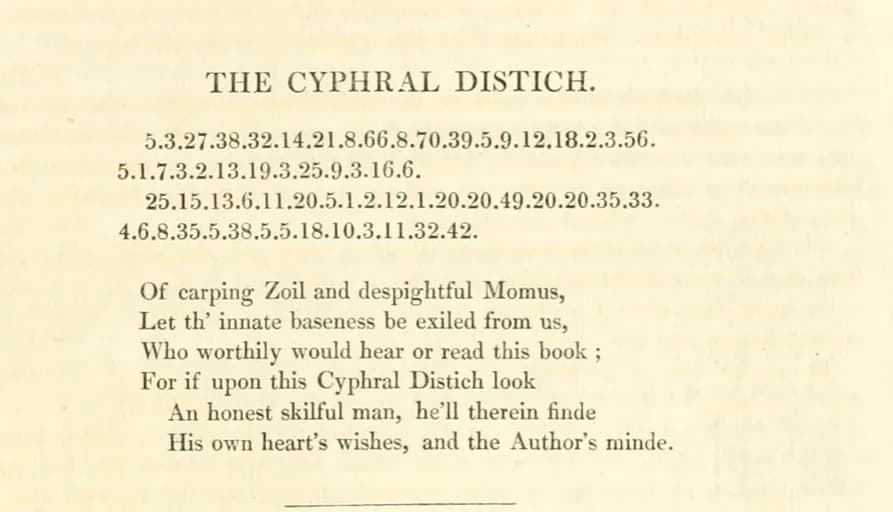
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。