開發工具
llama.cpp 推出更快的提示詞查詢草稿功能
Faster prompt lookup drafting in llama.cpp
jadidbourbaki.github.io · 2026-09-27
摘要
llama.cpp 實現了 Faster Prompt Lookup Drafting 技術,加速本地大語言模型的推理速度。通過優化提示詞查詢機制,使得草稿生成階段性能大幅提升,開發者能在資源受限的環境中獲得更流暢的推理體驗。
開源推理引擎 llama.cpp 在提示詞查詢解碼(prompt lookup decoding)技術上做了一輪優化,效果相當明顯。提示詞查詢草稿生成速度最高加快 42 倍,記憶體用量降到原本的 2.6 分之一。後續開發者 Daniel Lemire 又提交了額外優化,把整體加速幅度拉高到 140 倍。
技術原理
提示詞查詢解碼是推測性解碼(speculative decoding)的一種特殊應用,用 n-gram 模型當作極簡單的草稿生成工具。llama.cpp、vLLM 等多個常見推理引擎,還有 Hugging Face 的 transformers 函式庫,都支援這項技術來加快語言模型的語元生成速度。
n-gram 模型靠統計運作:系統先從文本語料庫中抓出連續 n 個語元組成的序列,統計每個 n-gram 出現的頻率。要預測某個語元序列後面接什麼語元時,模型就根據該序列在語料庫中最常接的語元來預測。
llama.cpp 維護三種 n-gram 快取結構:上下文快取存放模型正在處理的當前語元的 1 至 4 元 n-gram;動態快取保存模型先前執行留下的 n-gram 計數,例如早前的對話記錄;靜態快取存放從固定文本語料庫建構的二元 n-gram,由 llama-lookup-create 工具生成。
優化策略一:避免不必要的資料結構複製
第一項優化抓到 n-gram 快取在每個草稿步驟裡重複複製的問題。內層映射被多次不必要地複製,改成以參考方式讀取後,提示詞查詢速度立即提升 4.5 倍到 25.6 倍,改善幅度依語料庫大小而定。
優化策略二:替換雜湊表實現
llama.cpp 原本用 C++ 標準庫的 std::unordered_map 來實作 n-gram 快取的內外層映射。標準實現因為用鏈式碰撞解決方案,效能不好。優化後改用 Martin Ankerl 設計的 unordered_dense 映射方案。
這個改動帶來三方面的提升:靜態 n-gram 快取加載速度快了 1.41 倍到 1.65 倍;草稿生成速度快了 1.02 倍到 1.13 倍;靜態快取記憶體用量降了 1.07 倍到 1.11 倍。實作採用 ankerl::unordered_dense 的分段映射變體,這個設計以 4096 位元組為單位增長,避開了預設變體在記憶體翻倍時的問題。
優化策略三:內層映射結構調整
大多數 n-gram 只有少數幾個後續語元,用雜湊表對每個 n-gram 都維護內層映射很浪費記憶體。統計顯示,從 WikiText-103 語料庫建構的靜態快取中,64% 的二元 n-gram 只有一個後續語元。
優化方案改用排序向量取代內層的 std::unordered_map。為了處理少數高頻二元 n-gram 可能有數千個不同後續語元的狀況,採用排序向量搭配二分搜尋,維持 O(log n) 的搜尋複雜度。
實作進一步優化了二分搜尋的演算法設計。標準的 std::lower_bound 每次迭代都要靠記憶體讀取結果來決定迴圈跑幾次,容易造成快取未命中。改進版本把長度遞減和比較運算拆開,讓 CPU 能在前一次搜尋結果還沒回來時就繼續評估迴圈條件。
跟用平面雜湊表相比,這項優化讓草稿生成速度提升 2.09 倍(沒有靜態快取時)到 1.19 倍至 1.25 倍(有靜態快取時);尖峰記憶體用量最多降了 1.97 倍。
優化策略四:靜態快取改用不變映射
因為 llama.cpp 在加載後不會再修改靜態快取,開發者採用 Daniel Lemire 開發的 constmap 實現。constmap 是基於二元融合過濾器的不可變字符串對應 64 位整數的映射。
作法是把二元 n-gram 跟其後續語元計數對打包成連續陣列,constmap 只儲存該陣列的起始位置與計數。靜態快取檔案依序包含標題、語元對陣列,以及序列化的 constmap。
這項優化讓靜態快取加載速度提升 6.32 倍到 16.12 倍,以 541 MB 語料庫為例,從 3.76 秒降到 0.23 秒;靜態快取記憶體用量跟其檔案大小相當,同樣以 541 MB 語料庫為例,從 1.71 GB 尖峰記憶體降到 1.31 GB;有靜態快取時草稿生成速度快了 1.06 倍到 1.20 倍。
Daniel Lemire 的閾值檢查優化
Daniel Lemire 後續又提交了優化方案,改了 llama.cpp 檢查語元是否符合預設閾值的方式。原本系統會先算出所有候選語元的評分,再去檢查閾值;新方案改成先檢查最高頻的後續語元能不能通過閾值,如果這個語元就沒過,其他候選語元也一定過不了,因此可以跳過後面的評分計算。這項優化讓草稿生成速度額外快了 4.2 倍(有靜態快取)到 1.9 倍(沒有靜態快取)。
實驗設置
優化工作在 Apple M4 Pro(14 核心、48 GB 記憶體)上評估,用 WikiText-103 資料集。測試方式是模擬模型輸出並重放測試文本,量測每生成語元的延遲、靜態快取加載時間,以及記憶體用量。除了評估完整的 541 MB 語料庫,也測了 25、50、100 與 200 MB 的語料庫規模。所有結果回報中位數(3 次執行),誤差條顯示最小與最大值。
●開發者:可直接應用於本地 LLM 部署,降低推理延遲與資源消耗
●投資人:本地推理優化技術持續演進,邊緣計算應用潛力擴大
●一般用戶:本地 AI 應用響應速度改善,隱私保護選項更具競爭力
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Midjourney 與 Stable Diffusion 比較 2026:生成式圖像工具選哪一個?
2026 年 Midjourney vs Stable Diffusion 深度比較!分析本地部署、免費版限制與專業功能,助您從 AI 繪圖工具推薦中選出最適合的解決方案。
閱讀指南 →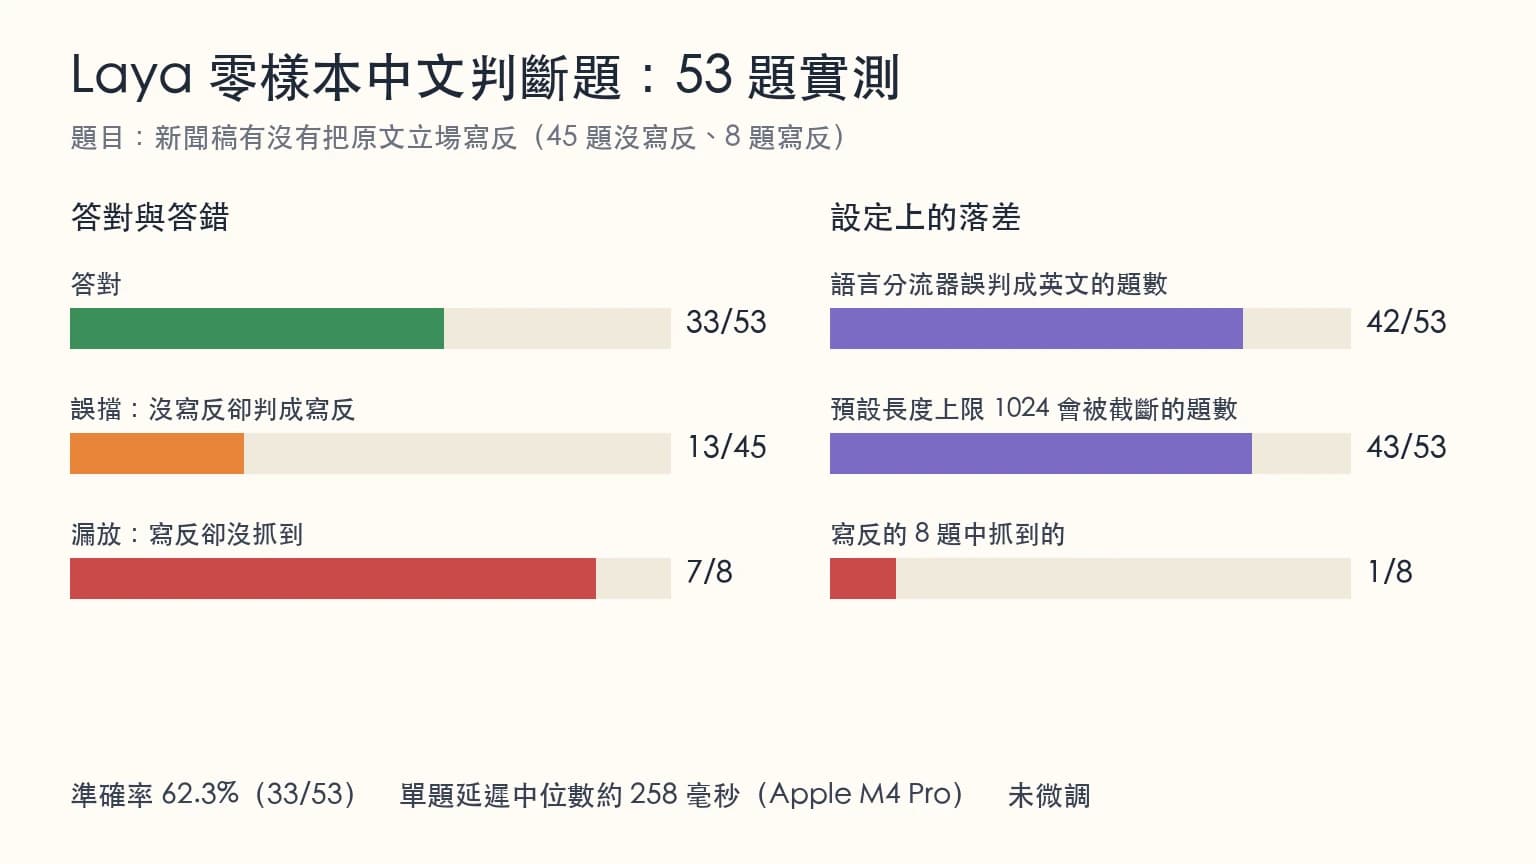
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →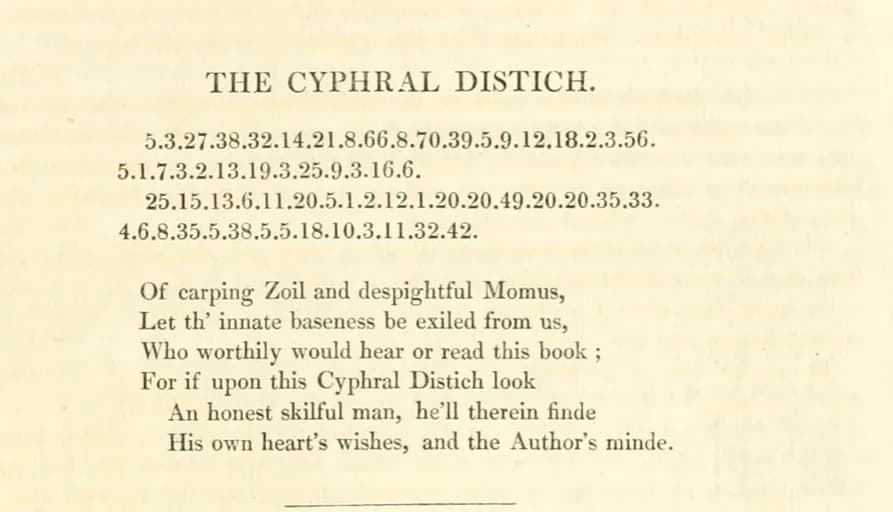
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。