研究突破
Agent Lightning v1.0:輕量級 Agentic RL 框架,讓 Agent Harness 直接參與強化學習
Agent Lightning v1.0: A 3,500-Line Lightweight Agentic RL Framework for Training Agents with Real Harnesses
www.microsoft.com · 2026-10-07
摘要
Microsoft Research Asia 推出 Agent Lightning v1.0,這是一個約 3,500 行程式碼的輕量級強化學習框架。其核心創新在於讓部署時使用的 Agent Harness 直接參與訓練,無需重新實作,並原生支援 Kubernetes 環境。實測顯示,該框架能利用僅約 6,000 筆樣本,將 Qwen3.5-9B 在 SWE-bench Verified 上的 Pass@1 分數提升 14.6 個百分點。
微軟亞洲研究院推出 Agent Lightning v1.0
微軟亞洲研究院(Microsoft Research Asia)正式發布 Agent Lightning v1.0,這是一個要解決強化學習(RL)與實際部署環境脫節問題的輕量級框架。框架的核心做法是提出「Harness 參與的強化學習」(Harnessed Agentic RL)訓練範式,讓部署時使用的 Agent Harness 直接參與訓練,不必重新實作代理程式。整個框架僅約 3,500 行程式碼,原生支援 Kubernetes 環境,不必依賴付費的沙盒服務。實測顯示,該框架利用約 6,000 筆樣本,將 Qwen3.5-9B 在 SWE-bench Verified 上的 Pass@1 分數從 41.8% 提升至 56.4%,增幅為 14.6 個百分點。
突破傳統 Agentic RL 的限制
傳統 Agentic RL 系統通常假設訓練框架掌握與環境互動的迴圈。在 ReAct 風格的迴圈中,模型生成動作,環境回傳觀察結果,並附加到上下文,整個 rollout 對應成連續的 token 軌跡。早期系統如 verl、AReaL 和 slime 都採用這種架構,所以訓練代理程式時,必須在 RL 框架內重建它的迴圈。不過,隨著 AI 代理從單一模型演變為由模型、工具和執行環境組成的複雜全棧系統,其能力愈來愈依賴模型外部的 Agent Harness。
現有的編碼代理程式(如 mini-SWE-agent、OpenHands、OpenCode、Claude Code 和 Codex)各有自己的上下文管理、工具協議、執行邏輯和依賴項。為了訓練而重建這些代理程式,不只成本高,重建後的行為還可能和部署版本不一致。Agent Lightning v1.0 改走另一條路,在代理程式與模型之間放一個 LLM 代理(LLM proxy)。代理程式照常運行,只要把原本呼叫模型 API 的端點指向 Agent Lightning,訓練框架就能觀察並記錄它的模型呼叫。這個範式正式定義為 Harnessed Agentic RL,也就是部署時使用的任何 Agent Harness,都直接參與強化學習訓練。
解決真實 Harness 訓練的四大挑戰
在 Harnessed Agentic RL 中,環境互動迴圈由 Agent Harness 而非訓練框架處理。訓練系統只能看到一連串 LLM 請求與回應配對,因此單一 rollout 可能分裂成數量不定的訓練樣本。這帶來四個關鍵挑戰:
1. 重新分詞與樣本合併:Harness 以文字形式保存上下文,但 RL 訓練需要 rollout 期間採樣的 token ID。如果把文字重新通過聊天模板和 tokenizer,token 邊界可能改變,導致相鄰呼叫不一定能合併成單一樣本。 2. 優勢計算:重新分詞、子代理程式和上下文摘要,都可能把單一 rollout 分裂成多個樣本。若直接在樣本層級計算基準和優勢,產生較多樣本的 rollout 會被重複計算,rollout 層級原本的統計關係也會因此改變。 3. 損失正規化:按樣本數量平均損失,會讓產生較多樣本的 rollout 權重更大。由於樣本數量往往取決於 Harness 的行為,損失正規化必須避免因此失真。 4. 訓練後端調度:樣本數量和長度要等 Harness 跑完才知道,但 GPU 數量和資料/張量並行配置通常是固定的。後端必須把可變的工作負載對應到固定資源上。
輕量級架構與 Collocated Async RL
Agent Lightning v1.0 以簡潔為首要原則,包含三個核心組件:API 閘道、Rollout 控制器和自訂訓練器。API 閘道儲存 rollouts、模型和事件,作為 OpenAI 相容的 LLM 代理,連接 Harness 的每次模型呼叫,並記錄提示、回應和對數概率。Rollout 控制器負責啟動和管理代理程式執行,可作為本地進程或標準 Kubernetes 作業運行,讓代理程式執行與訓練器分離。自訂訓練器以 verl 為基礎,負責建立 rollouts、等待完成、收集樣本,並透過樣本適配器組裝最終的訓練樣本。
針對 Rollout 的時間差異,Agent Lightning v1.0 引入「共置非同步強化學習」(Collocated Async RL)。同步 RL 要等批次中最慢的代理程式,造成 GPU 閒置;完全非同步 RL 雖然提高利用率,但 rollout 和訓練各需要獨立的 GPU 池。Collocated Async RL 讓 rollout 和模型更新共用同一組 GPU。收集到足夠的 rollouts 後開始更新:API 閘道暫停接受新請求,等進行中的請求完成,更新結束後 rollout 再恢復。這個狀態轉換對外部代理程式是透明的。實驗顯示,此方法比同步 RL 的端到端速度快約 2 倍,使用的 GPU 也比傳統非同步 RL 少。
Kubernetes 原生支援與效能驗證
要收集足夠的 rollouts,就得同時運行大量代理程式,耗用大量 CPU、記憶體和運算資源。其他 Harnessed Agentic RL 框架常把代理程式放在 Modal Sandbox 或 E2B 等商業沙盒服務上,規模一大,成本就快速上升。Agent Lightning v1.0 則把代理程式當成標準 Kubernetes 作業運行,重用現有的自管叢集、雲端 Kubernetes 或本地基礎設施,提高現有運算資源的使用效率,降低大規模 rollout 的成本,並維持開源與可重現性。
在編碼代理程式實驗中,研究人員以 SWE-smith、mini-SWE-agent 和 Qwen3.5-9B 建立完整管線,涵蓋資料清理、環境建構、獎勵作弊防護和 RL 訓練。訓練集只有約 6,000 筆樣本,不需要大型運算。RL 訓練讓 Qwen3.5-9B 在 SWE-bench Verified 上的表現從 41.8% 提升至 56.4%。實驗也進一步驗證了優勢計算與損失正規化的挑戰:和樣本層級處理相比,rollout 層級的優勢搭配 rollout 層級的正規化,在訓練期間取得更高的驗證獎勵,政策熵也更穩定。
●開發者:可採用此輕量框架優化 Agent 訓練流程,降低對商業沙盒服務的依賴
●投資人:關注 AI Agent 訓練效率提升與成本降低的技術趨勢
●一般用戶:間接受惠於更穩定、高效的 AI 程式輔助工具
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →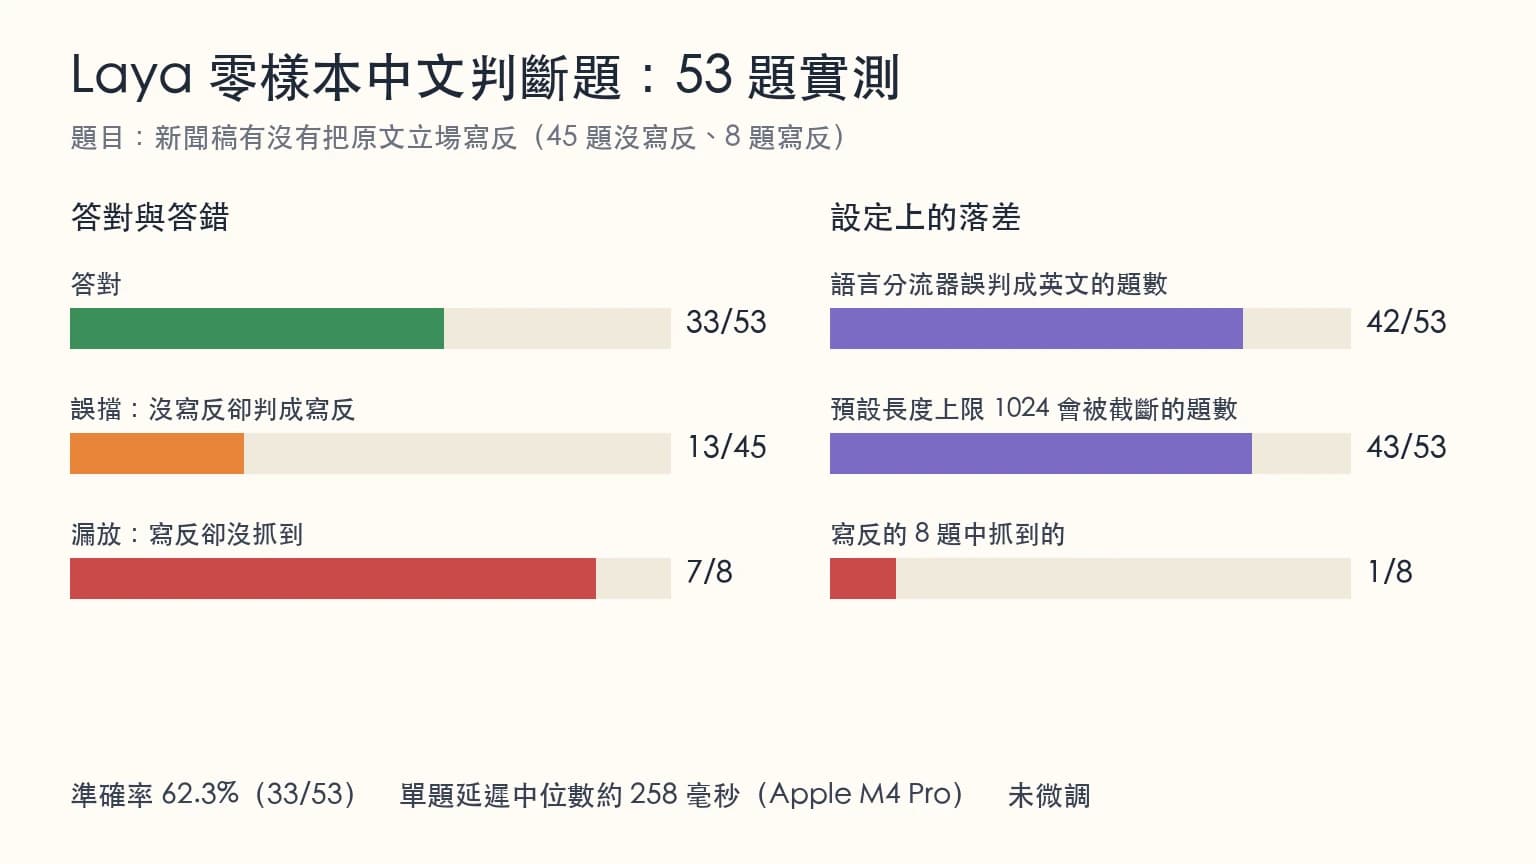
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →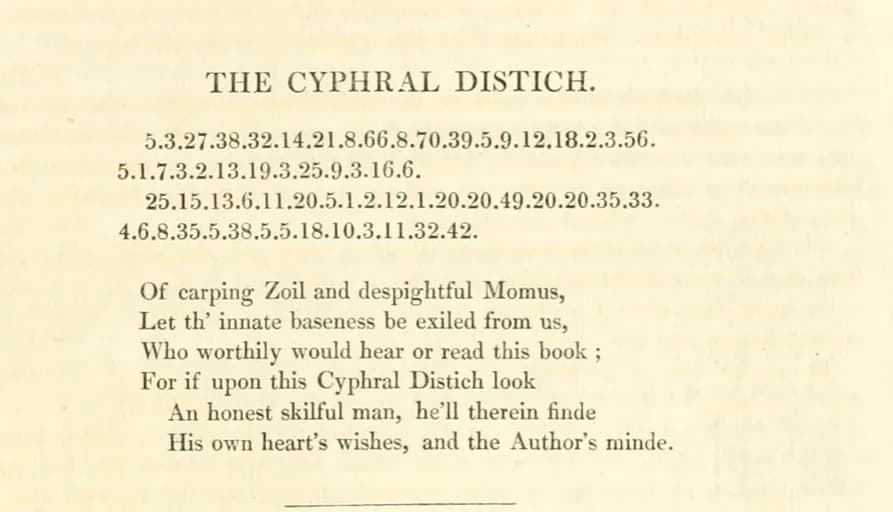
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。