開發工具
GLM5.3-Flash-E224-DGX-Spark:針對 NVIDIA DGX Spark 優化的非官方模型部署指南
autotrust/GLM5.3-Flash-E224-DGX-Spark
Hugging Face · 2026-10-06
摘要
autotrust 發布了基於 zai-org/GLM-5.3-Flash 的壓縮版本,專為 NVIDIA DGX Spark 桌面系統設計。該模型透過神經架構搜尋(NAS)保留 224 個專家,並採用 NVFP4 技術,在僅激活 180 億參數的情況下,將權重大小控制在 141 GiB,適合雙卡 DGX Spark 部署。官方同步提供了完整的部署 Runbook,涵蓋網路設定、記憶體配置及效能基準測試數據。
autotrust 發布基於 zai-org/GLM-5.3-Flash 的非官方壓縮版本 GLM5.3-Flash-E224-DGX-Spark,專為 NVIDIA DGX Spark 等桌面 Blackwell 系統設計。該模型透過神經架構搜尋(NAS)將每層路由專家從 288 個精簡至 224 個,並採用 NVFP4 格式儲存專家權重,在維持每 token 180 億活躍參數的前提下,將權重大小壓縮至 141 GiB。此配置適合雙卡 DGX Spark 部署,兩節點總計 256 GiB 統一記憶體中,每節點約佔用 70 GiB 權重,剩餘約 40 GiB 可用於 KV 快取,支援 128K+ 推理追蹤。
部署指南提供 vLLM 0.31.0 設定,使用 Tensor Parallelism (TP=2) 透過 ConnectX-7 連接兩節點,並啟用 FP8 KV 快取。在單顆 B200 GPU 上的基準測試顯示,單流吞吐量為 15.7 tok/s,8 路並發下達 71.8 tok/s,兩顆 GPU 利用率約 96%。效能方面,在 GPQA-Diamond 與 AIME 2025 等基準測試中,其表現與未剪枝的 NVFP4 參考模型相當,誤差在噪音範圍內。
模型保留完整 154,880 詞彙表及視覺塔,支援 BFCL v4 工具使用測試,整體準確率達 88.3%。
●開發者:可參考針對 DGX Spark 的 vLLM 部署與效能優化實戰經驗
●投資人:關注邊緣 AI 硬體與高效能模型壓縮技術的商業化潛力
●一般用戶:此為底層技術更新,短期無直接影響
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →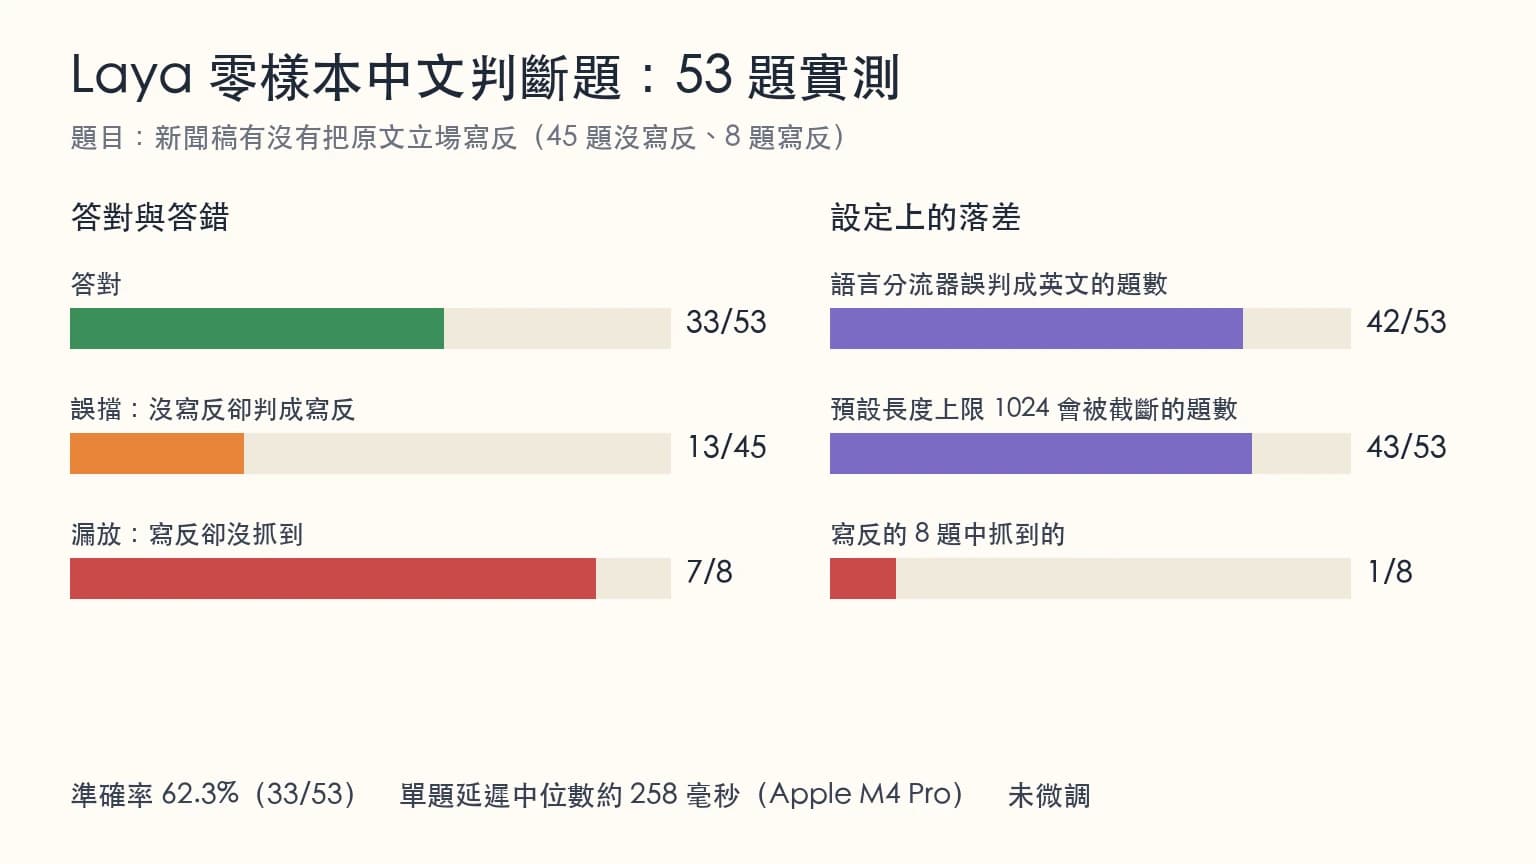
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →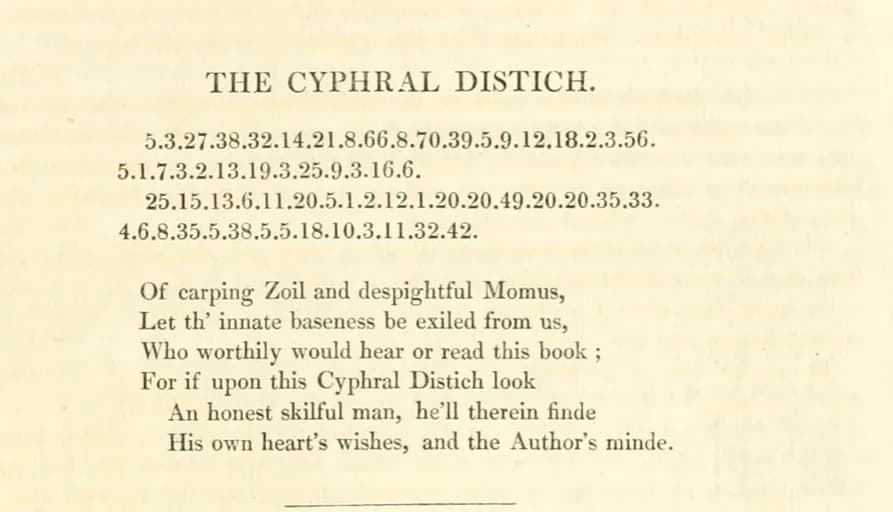
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。