開發工具
Harness Engineering 解析:如何評估、迭代與保護 AI 程式碼代理
The Anatomy of Harness Engineering: How to Evaluate, Iterate, and Guard AI Coding Agents
developers.googleblog.com · 2026-10-12
摘要
Google Developers 提出針對 AI 程式碼代理(AI Coding Agents)的評估方法,指出傳統端到端基準測試(如 SWE-bench)成本高且缺乏根因診斷能力。建議開發者採用行為評估(Behavioral Evaluations),透過快速、本地的單元風格測試來驗證中間動作,從而建立微觀檢查機制,確保在迭代系統提示與升級模型時能避免回歸問題。
傳統基準測試的盲點與高成本困境
Principal Engineer Taylor Mullen 與 Staff Software Engineer Christian Gunderman 指出,開發者在建構 AI 程式碼代理系統的評估機制時,常陷入同一個迷思:只靠 Terminal-Bench 或 DeepSWE 等端到端基準測試。這類測試雖是評估模型表現的標準做法,但綜合分數出現小幅波動時,開發者往往搞不清楚原因。是模型對模糊提示過度自信?還是漏掉了驗證步驟?端到端測試通常給不出這些根因診斷,而要深入調查這些問題,成本又往往很高。
行為評估:從報告卡轉向導航指標
針對上述問題,團隊建議採用「行為評估」(Behavioral Evaluations),作為更可靠的信心指標。傳統評估方式像學生考試,只計算最後通過的測試數量;行為評估則比較像整合測試,重點在驗證代理系統有沒有做出預期的中間動作。開發者建立豐富的行為評估集後,就能確立代理系統的行為基準,在調整系統提示或升級模型時,立刻發現是否出現倒退。這種方法不只能確認方向正確,也能當作迭代時的夥伴,具體呈現每次變更的影響。
架構設計:本地化單元風格檢查
行為評估的核心架構,是把行為斷言獨立出來,做成快速、確定性的本地單元風格檢查。焦點因此從複雜的多檔案重構,轉到可以觀察的離散動作。例如,提示資訊不足時,代理是會提問澄清,還是直接猜測?修改建置檔案時,有沒有先執行本地驗證器?生成文件時,有沒有附上標準倉庫連結?這些細小的斷言構成一道安全網,開發者在調整提示或更換模型時,馬上就能知道核心行為有沒有被破壞,也就建立起微觀檢查機制。
開發階段:先實測後評估
在評估時機上,團隊強調「自我食用」(Dogfooding)要先行。代理系統還沒有能力處理範本程式碼、撰寫 Markdown 渲染器、執行日常開發任務之前,沒有必要建立複雜的評估框架。評估屬於開發的第二階段,主要目的不是慶祝代理效能提升了幾個百分點,而是確保新的提示調整、工具架構變更或模型升級,沒有讓系統整體表現變差。這種做法是要提供穩固的信心,避免迭代過程中出現意外倒退。
實作範例與自動化循環
撰寫行為評估時,斷言應針對中間執行步驟(如特定工具呼叫或檔案修改),而不是最終字串是否相等。以 Google Antigravity SDK 為例,測試程式碼可以驗證代理是否使用網路搜尋工具取得即時天氣資訊,而不是只憑記憶回答。這種自動化機制可以結合提示工程,讓 LLM 自動調整系統提示,直到失敗的測試通過;其餘測試套件則像 CI/CD 的防護欄,確保新功能不會破壞現有功能。
建立穩定評估套件的三步驟
為了讓過程可以重複執行,建議從簡單的三步行為測試循環開始。首先,選定一個具體的失敗模式當目標,例如代理忘記執行單元測試就標記任務完成。其次,依任務複雜度撰寫有彈性的斷言:單一最佳解的簡單任務,使用嚴格的單輪斷言;複雜任務則避免強制規定僵化的工具序列,改用以結果為準的檢查(如 LLM 作為評判),容納模型可能採取的非常規但正確的路徑。最後,把批次評估自動化以監控穩定性,追蹤聚合通過率的趨勢,而不是依賴單一評估結果,因為模型的非確定性可能讓單次結果出現噪音。這樣開發者就能放心微調提示與升級模型。
宏觀與微觀評估的互補關係
行為評估不是要取代大型端到端評估套件,而是與它互補。宏觀基準測試驗證最終目的地,微觀行為評估則是夥伴,支援安全而快速的迭代。兩者並用,開發者在變更提示、開發新功能或部署新模型時,會更有信心。最終目標是把評估框架當成需要單元測試與整合測試的標準軟體,而不只是黑盒考試,藉此建構穩定且有韌性的代理系統保護機制。
●開發者:可採用行為評估與微觀檢查機制,提升 AI 程式碼代理的迭代穩定性與除錯效率
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →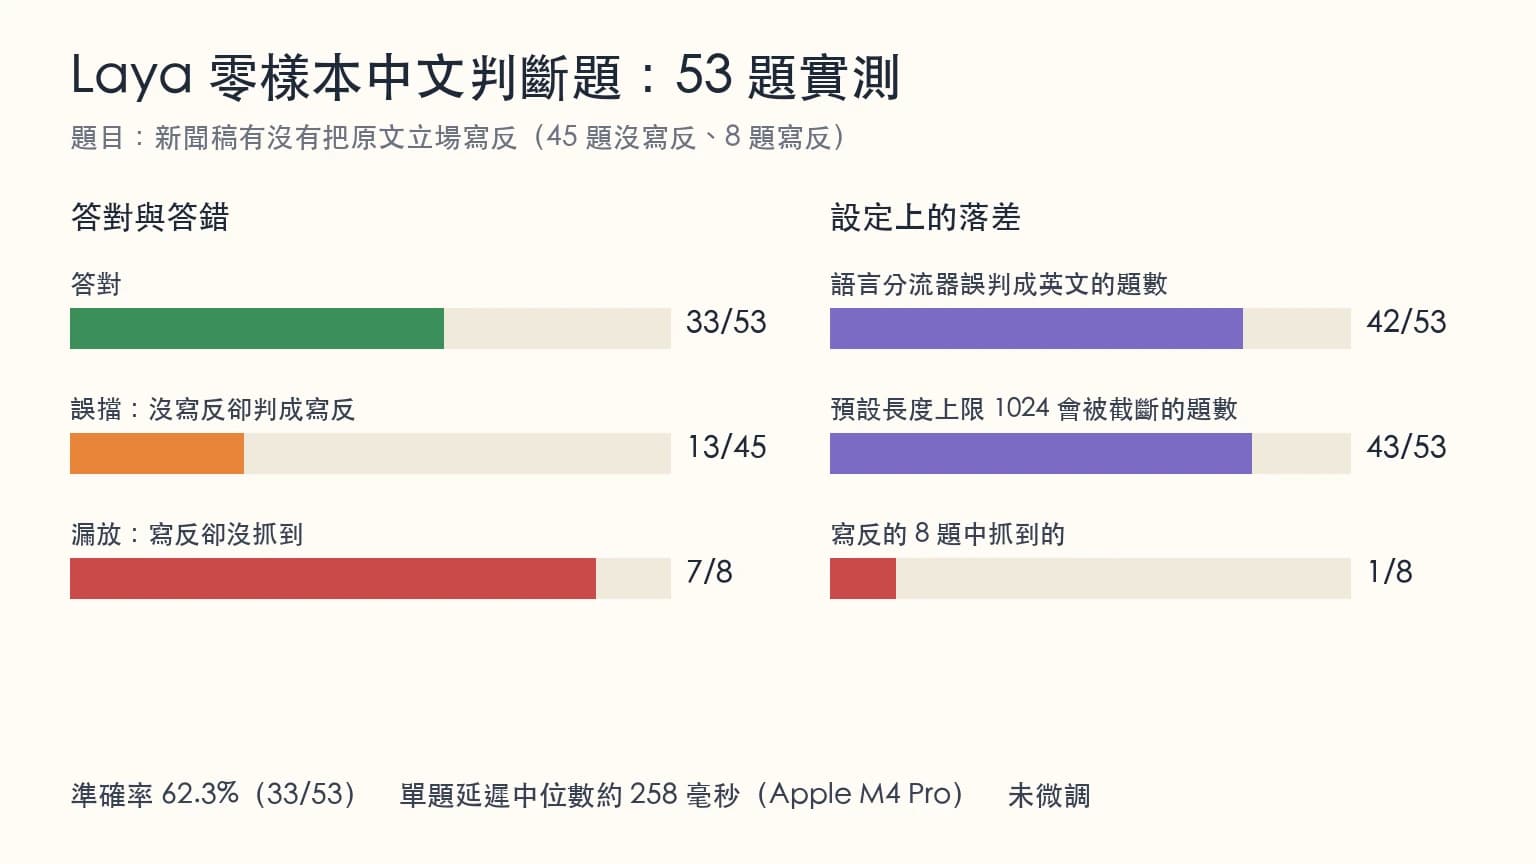
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →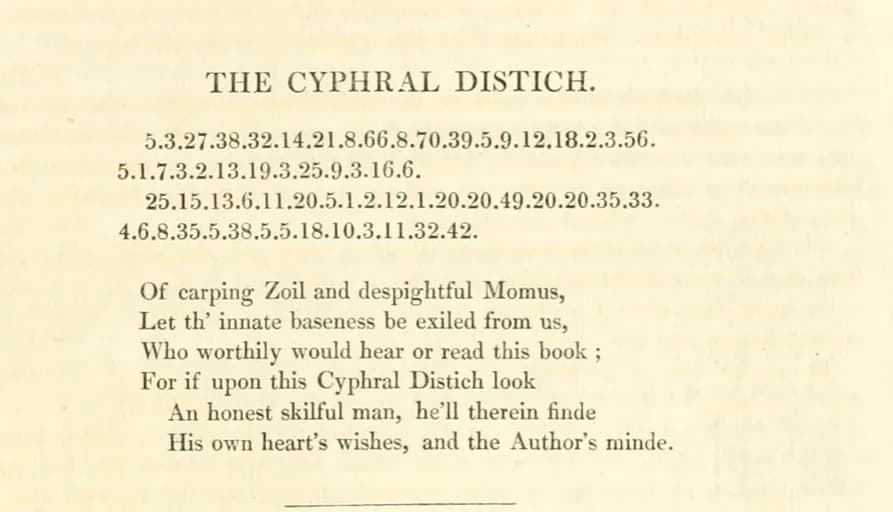
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。