硬體基建
Google Cloud 原生整合 TPU 支援至 vLLM,優化長上下文多模態嵌入推論
Enterprise-Grade Precision for Long-Context Multimodal Embedding Inference on Cloud TPU
Google Developers · 2026-10-12
摘要
Google Cloud 宣布將 TPU 支援原生整合進 vLLM 推論引擎,並透過 Google Kubernetes Engine (GKE) 實現嵌入管線的高彈性擴展。針對 Qwen3-Embedding-8B 等模型處理 15K+ token 長上下文的需求,工程團隊實作了硬體張量對齊、JAX/XLA 編譯預熱及混合 StepPool 架構等 TPU 專屬優化,達成與 GPU 基準近乎完美的數值一致性。開發者可透過 AI-Hypercomputer GitHub 上的開源設定範例,立即建構高吞吐量的語義檢索應用。
Google Cloud 宣布將 TPU 支援原生整合進 vLLM 推論引擎,並透過 Google Kubernetes Engine (GKE) 實現嵌入管線的高彈性擴展,旨在解決處理如 Qwen3-Embedding-8B 等模型時,面對 15K+ token 長上下文的需求。
工程團隊實作了多項 TPU 專屬優化技術,包含硬體安全的張量對齊、JAX/XLA 編譯預熱,以及用於分塊預填充管理的混合 StepPool 架構,確保系統在處理大量上下文數據時的穩定性與效率。這些改進使 TPU 環境下的推論結果與參考 GPU 基準達成近乎完美的數值一致性,讓開發者在遷移或部署時,能獲得與 GPU 環境高度一致的計算結果,減少因硬體差異導致的精度損失。
為降低使用 TPU 進行大規模嵌入推論的門檻,Google 已將相關設定範例開源至 AI-Hypercomputer GitHub。開發者可直接利用這些開源的設定配方,立即建構高吞吐量的語義檢索應用,無需從零開始配置複雜的硬體與軟體環境,提供了即用的最佳實踐方案。
●開發者:可參考開源設定優化 vLLM 在 TPU 上的效能
●投資人:Google Cloud 強化 AI 基礎設施競爭力
●一般用戶:無直接影響
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →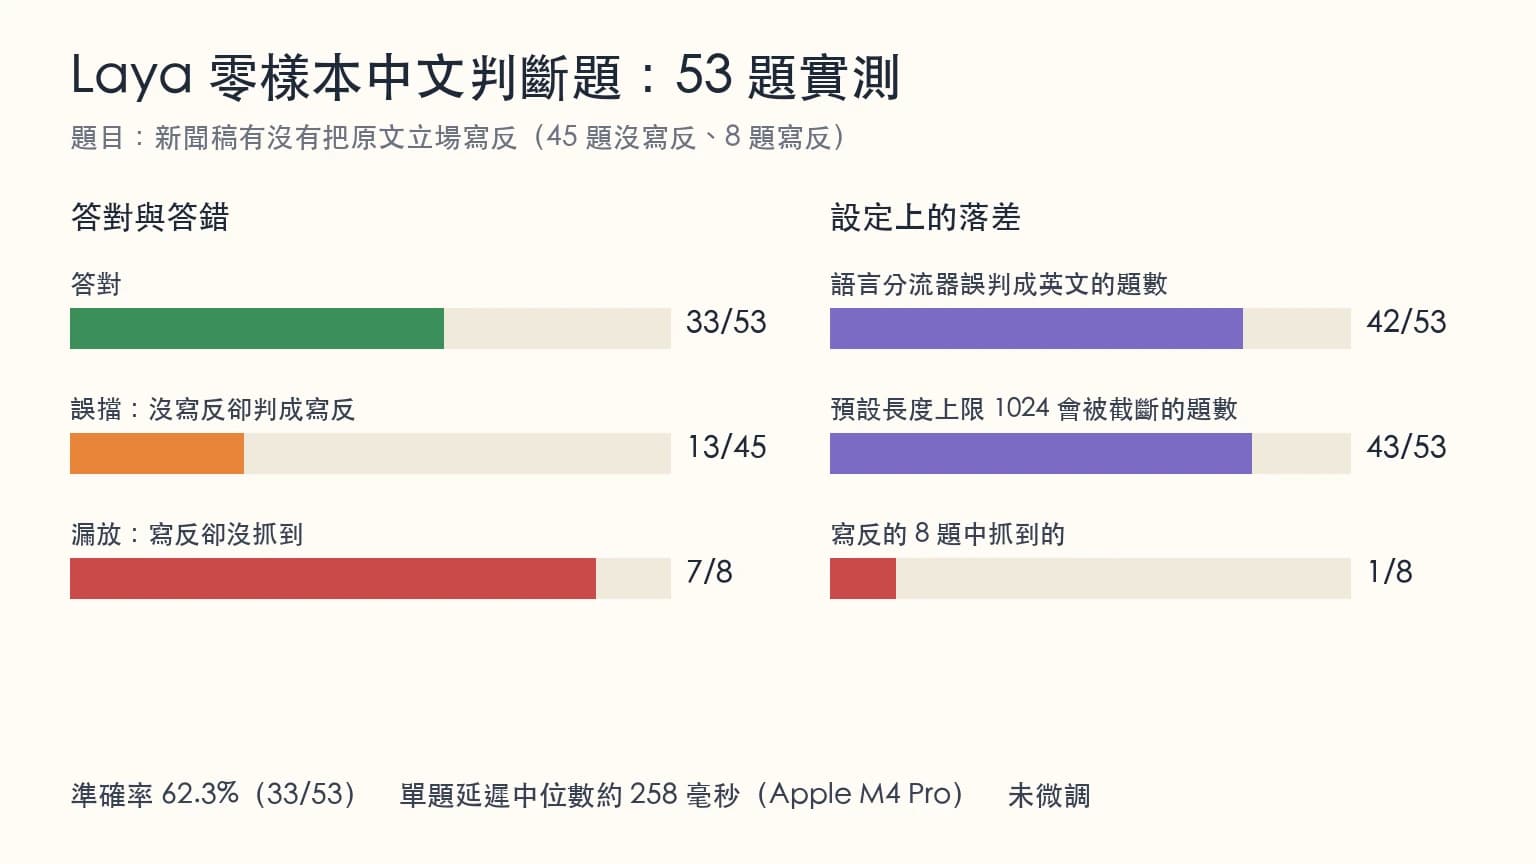
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →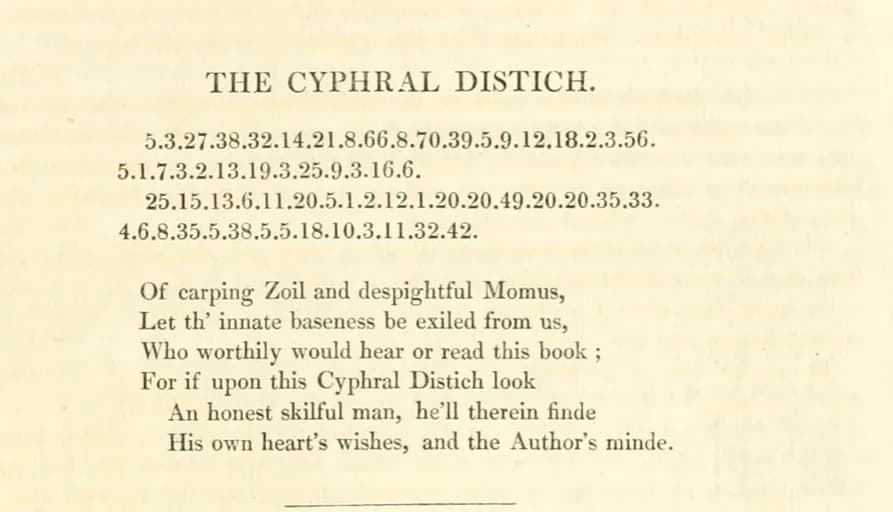
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。