產品發佈
Kimi 持續挑戰前沿:K3.1 Pro 發布,即將開放免費權重
Kimi continues to challenge the frontier with K3.1 Pro
www.kimi.com2026-10-26
摘要
中國 AI 實驗室 Moonshot 發布 Kimi K3.1 Pro,在關鍵基準測試中表現匹敵最強的專有模型。根據 Artificial Analysis 排名,該模型已躋身全球第四,且將於 11 月 4 日開放免費下載權重,有望成為最強開源模型之一。
Kimi 宣布推出 Kimi K3.1 Pro,該模型今日已在全系產品中正式上線,涵蓋 Kimi.com、Kimi 行動應用程式、Kimi Work、Kimi Code 以及 Kimi API。Kimi 同時宣布,完整模型權重將於 2026 年 11 月 4 日前開放。
Kimi K3.1 Pro 是 Kimi K3 的後訓練版本,具備大幅增加的後訓練算力。為了在數百個下游領域實現大規模聯合強化學習,開發者優化了堆棧的每一層,包括強化學習框架、長上下文推理、訓練效率、沙盒基礎設施、rollout 排程以及環境品質檢查的共享平台。由於上述優化,每增加一份強化學習算力都能帶來穩定且可預測的回報,K3.1 Pro 因而在每個領域都取得一致的提升。
在編程、代理和知識基準測試中,Kimi K3.1 Pro 的性能匹配或接近最強的專有模型。在評估編程代理在資源受限終端任務上表現的 Terminal-Bench 4.0 基準測試中,Kimi K3.1 Pro 得分 65.7%,高於 GPT-6 Astra 的 58.2%,並略低於 Claude Opus 5.5 的 66.4%。在測試編程代理在多步驟執行、工具使用和跨多樣工程領域端到端問題解決能力的內部基準測試 Kimi Code Bench 3.0 Long-horizon 中,Kimi K3.1 Pro 得分 61.2%,高於 K3 的 55.95%。
Kimi K3.1 Pro 在遊戲和網頁體驗方面帶來了更經過深思熟慮的視覺風格,並知道如何使用正確的工具進行構建。Kimi K3.1 Pro 在 Unity、Unreal Engine 和 Godot 等遊戲引擎中有效運作,並將它們與網頁搜索和 3D 生成相結合,以創建完整的體驗。其前端頁面、互動式 Three.js 場景和 3D 資產在構圖、排版、動畫和打磨方面表現出更強的表現。
此外,Kimi 也發布了 Kimi K3.1 Pro Highspeed,其運行速度是 K3.1 Pro 的 2 至 3 倍,可提供更快速的互動體驗。
Kimi K3.1 Pro 在編程、3D 創作、金融研究及其他代理能力方面帶來了顯著改進。用戶可透過以下方式體驗 Kimi K3.1 Pro:下載或更新最新版的 Kimi 行動應用程式(支援 iOS、Android 和 HarmonyOS),或訪問 kimi.com;下載最新版的 Kimi Work 桌面應用程式(版本 3.1.0 或更高,支援 Windows 和 Apple silicon Macs);在 Kimi Code 中使用 /model 命令選擇 Kimi K3.1 Pro;或訪問 Kimi API 平台並選擇 kimi-k3.1-pro / kimi-k3.1-pro-highspeed,API 客戶可使用 Zero Data Retention 功能。
Kimi Enterprise 管理員可以為其組織啟用 K3.1 Pro;在發布時,存取預設為關閉。Kimi Business 提供企業級資料隱私和成員管理,個人與組織帳戶完全分離,團隊可前往定價頁面選擇「Get Kimi Business」進行訂閱。
除非另有說明,以下報告的所有 Kimi K3.1 Pro 結果均使用推理努力設為 'max'、temperature = 1.0 和 top-p = 0.95 獲得。在 Terminal-Bench 4.0 中,Kimi K3.1 Pro 使用 Claude-Code harness 進行評估。在 Terminal-Bench-Science 0.1 中,Kimi K3.1 Pro 使用 Claude-Code harness 進行評估。在 DeepSWE v1.1 中,Kimi K3.1 Pro 使用 Claude-Code harness 進行評估。在 SWE-Marathon v1.1 中,Kimi K3.1 Pro 使用 Claude-Code harness 進行評估。在 PostTrainBench 中,Kimi K3.1 Pro 和 DeepSeek-V4.1-Flash-1017 使用 Claude-Code harness 和 H20 GPU 在內部進行評估。在 ProgramBench 中,Kimi K3.1 Pro 使用 Claude-Code harness 進行評估。在 OfficeQA Pro 和 OfficeQA Pro v2 中,GPT-6 Astra 使用 Codex 進行評估,而其他所有模型均使用 Claude Code 進行評估。每個任務均向代理提供整個 PDF 語料庫,所有 PDF 均渲染為影像且無機器可讀文字。在 Frontier Finance 中,使用官方 finance agent v2 harness 進行評估。在 HANDBOOK.md 中,使用基於 OpenHands 的官方 harness 進行評估。在 Harvey Legal Agent 中,使用 Artificial Analysis 的 Stirrup harness 在 1,251 個任務的公開資料集上進行評估。在 OSWorld V2.1 中,使用 Kimi Agent harness 在官方 OSWorld v2 儲存庫中進行評估。在 DECK-Arena 中,模型在 python-pptx、pptxjs 和 Kimi 的內部 DSL 上運行,使用整合搜索和影像生成的 harness,並使用經過 10,000 多次人類判斷校準的自動化評分器。在 MCP Atlas 中,所有模型在 500 個任務的公開子集上進行評估,限制為 100 輪,使用 Gemini 3.1 Pro 作為評判。在 BrowseComp 中,採用在 200K 令牌時觸發的上下文壓縮策略,允許最多 500 個步驟,所有運行均使用 temperature=1.0 和 top-p=1.0。GDPval-AA v2.1、AA-Briefcase v1.1 和 AutomationBench-AA 分數引用自 w/ python、ZeroBench w/ python 和 ChartoGraphy w/ python 是五次運行的平均值。
●開發者:可關注 K3.1 Pro 的開源權重以進行本地部署或微調
●投資人:中國開源模型競爭力持續提升,關注 Moonshot 後續商業化
●一般用戶:11 月 4 日起可免費使用高階 Kimi 模型
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Qwen vs Kimi vs DeepSeek 2026 比較:亞洲主流模型功能與定價分析
深入分析 2026 年 Qwen vs Kimi vs DeepSeek 三大亞洲主流模型。涵蓋功能對比、長文本處理、定價方案及實戰教學,助您選擇最適合的 AI 工具。
閱讀指南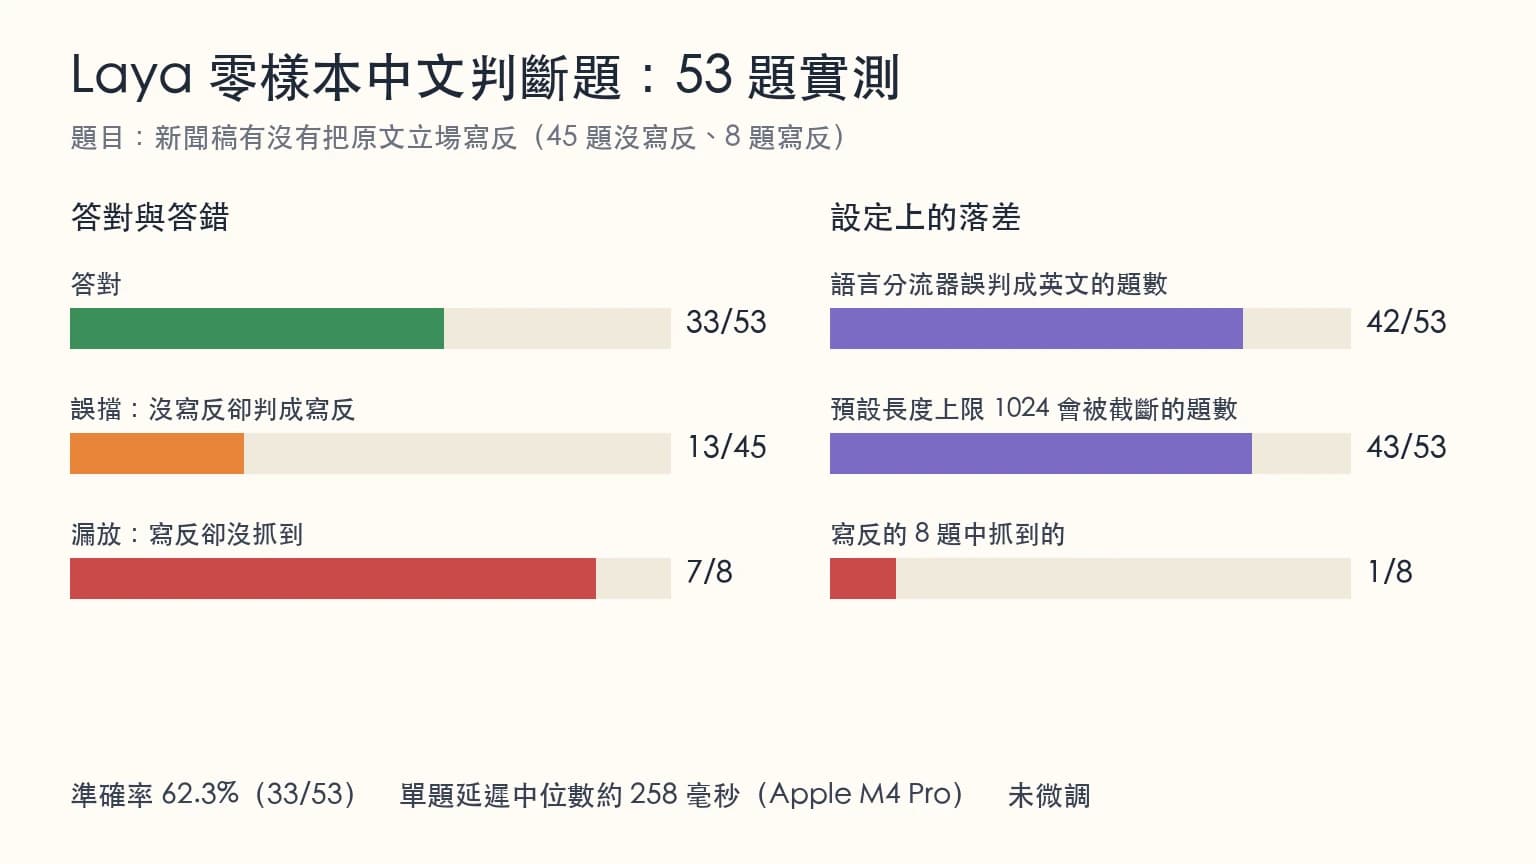
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。