企業商業
Building on open source AI?Hugging Face 政策主管談成本、風險與取捨
Building on open source AI? Hugging Face’s policy chief on the costs, risks, and trade-offs
huggingface.co2026-11-04
摘要
Hugging Face 政策主管探討開源 AI 模型日益主流化的趨勢,分析企業、政府與新創在追求低成本、控制權與靈活性時所面臨的挑戰。隨著具備更高能力的模型更自由地流通,文章聚焦於企業如何在此環境中捕捉價值,並探討在中國開源模型崛起的背景下,美國競爭者能否保持領先。
開源多模態巨獸登場:Mistral Large 4 技術細節與部署實錄
Hugging Face 正式引入由 Mistral 開發的多模態、多語言混合專家(MoE)模型 Mistral Large 4,又名「Le Chonk」。此模型具備接收文字與影像輸入,並生成文字輸出的能力。在參數量方面,Mistral Large 4 擁有約 1T 的總參數,其中活躍參數為 49B,並支援高達 1M tokens 的上下文視窗。官方提供兩種主要變體:FP8 與 NVFP4,同時 Unsloth 與 llama.cpp 團隊也製作了 GGUF 格式檔案。該模型採用 Mistral 生態系統開放權重許可(Mistral Ecosystem Open-Weight License),這是一種衍生自 MIT 的授權,對模型即服務的提供設定了限制。
架構創新與安全防禦優勢
Mistral Large 4 的語言模型解碼器包含 72 層,隱藏維度為 6,144,並配備 64 個注意力頭。其架構結合了多頭潛在注意力(MLA)與 DeepSeek 稀疏注意力(DSA)索引器,其中 DSA 可為每個查詢選擇最多 2,048 個鍵位置。在解碼塊中,模型採用 3:1 的 RoPE 與 NoPE 模式,即每四層中有一層使用 NoPE,且 KV 狀態在層間共享。除了第一層使用密集前饋網路外,其餘 71 層均使用 MoE 區塊,由 softmax 路由器為每個 token 選擇 128 個專家中的四個,加上一個始終運行的共享專家,每個 token 總共激活 5 個專家。
在安全領域,Mistral Large 4 在 Artificial Analysis 網路安全指數測試中獲得 82% 的分數,該測試要求模型復現開源軟體中的真實漏洞並進行修補。Mistral 指出,多個封閉式前沿模型在相同測試中得分接近零,因為它們拒絕執行此類工作。對於防禦者而言,復現漏洞通常是修補的必要步驟。該模型在惡意軟體分析、漏洞優先級排序及檢測規則編寫等內部測試中表現良好,儘管這些並非其明確訓練的目標。值得注意的是,儘管該模型定位於防禦性安全工作,但在 JailbreakBench、StrongREJECT 和 AgentHarm 的網路提示測試中,其平均拒絕率高於任何其他開放權重模型。
基準測試與多模態能力
截至 2026 年 10 月 29 日,Mistral Large 4 在 Artificial Analysis 智慧指數的開放權重模型中排名第五。在編碼能力方面,該模型在 DeepSWE v1.1 上達到 61.7%,在 SWE-Atlas-QnA 上達到 59.4%,在 Terminal-Bench 4 上達到 28.3%。其綜合編碼代理指數得分為 49.8%,超越了 DeepSeek V4 Pro 0813 和 Qwen3.8 Max。此外,在 AutomationBench 上得分 59.9%,在 AA-Briefcase 上獲得 1,393 Elo 分數,顯示其在業務工作流與長期專業任務中的潛力。
該模型還展現了強大的攻擊抵抗力,在 Lakera 的 B3 基準測試中達到 93.3% 的攻擊抵抗率。在 Cybench 測試中,它解決了來自安全競賽的 40 個挑戰中的 93%。視覺編碼器部分,Mistral Large 4 採用 1.6B 的 Pixtral 編碼器,擁有 30 層、2,048 的隱藏維度和 16 個注意力頭,使用 14 × 14 的 patches 和空間合併大小為 2 的合併投影器。
部署支援與效能表現
Mistral Large 4 提供 Transformers、vLLM 和 llama.cpp 的 Day-0 支援。在 Transformers 實現中,模型支援低、中、高三種推理努力程度,預設為高,且無法完全禁用推理。透過 vLLM,模型支援高品質的 NVFP4 檢查點,該檢查點記憶體佔用較小,並需要 NVIDIA Blackwell GPU。Llama.cpp 團隊提供了多種量化版本,包括 IQ2_XXS、Q2_K、Q4_K_M、NVFP4、Q8_0 和 BF16。其中,2 比特量化可在單一配備 512 GB 統一記憶體 Apple Silicon Ultra 電腦上運行。
在 Dell Enterprise Hub 上,透過 dell-ai CLI 可輕鬆部署於 NVIDIA H200、B200、GB200 或 GB300 伺服器。在 llama.cpp 上,於 4 張 RTX6000 Pro 運行 NVFP4 時,32K 上下文大小的預填充吞吐量為 130-590 t/s,生成速度約為 10 t/s。而在單一 M3 Ultra 上運行 Q2_K 量化時,預填充吞吐量約為每秒 90 個 token,生成速度為每秒 15 個 token。透過 Inference Endpoints,使用 8 張 NVIDIA H200 GPU 的配方可服務高達 131K tokens 的上下文,單次請求在 1K-token 提示下的首 token 時間約為 0.6 秒,生成速度約為每秒 65 個 token。
●開發者:需評估開源模型在商業應用中的成本與風險取捨
●投資人:關注開源生態系中價值分配與中美競爭格局
●一般用戶:開源模型普及可能帶來更多元且具競爭力的 AI 服務
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
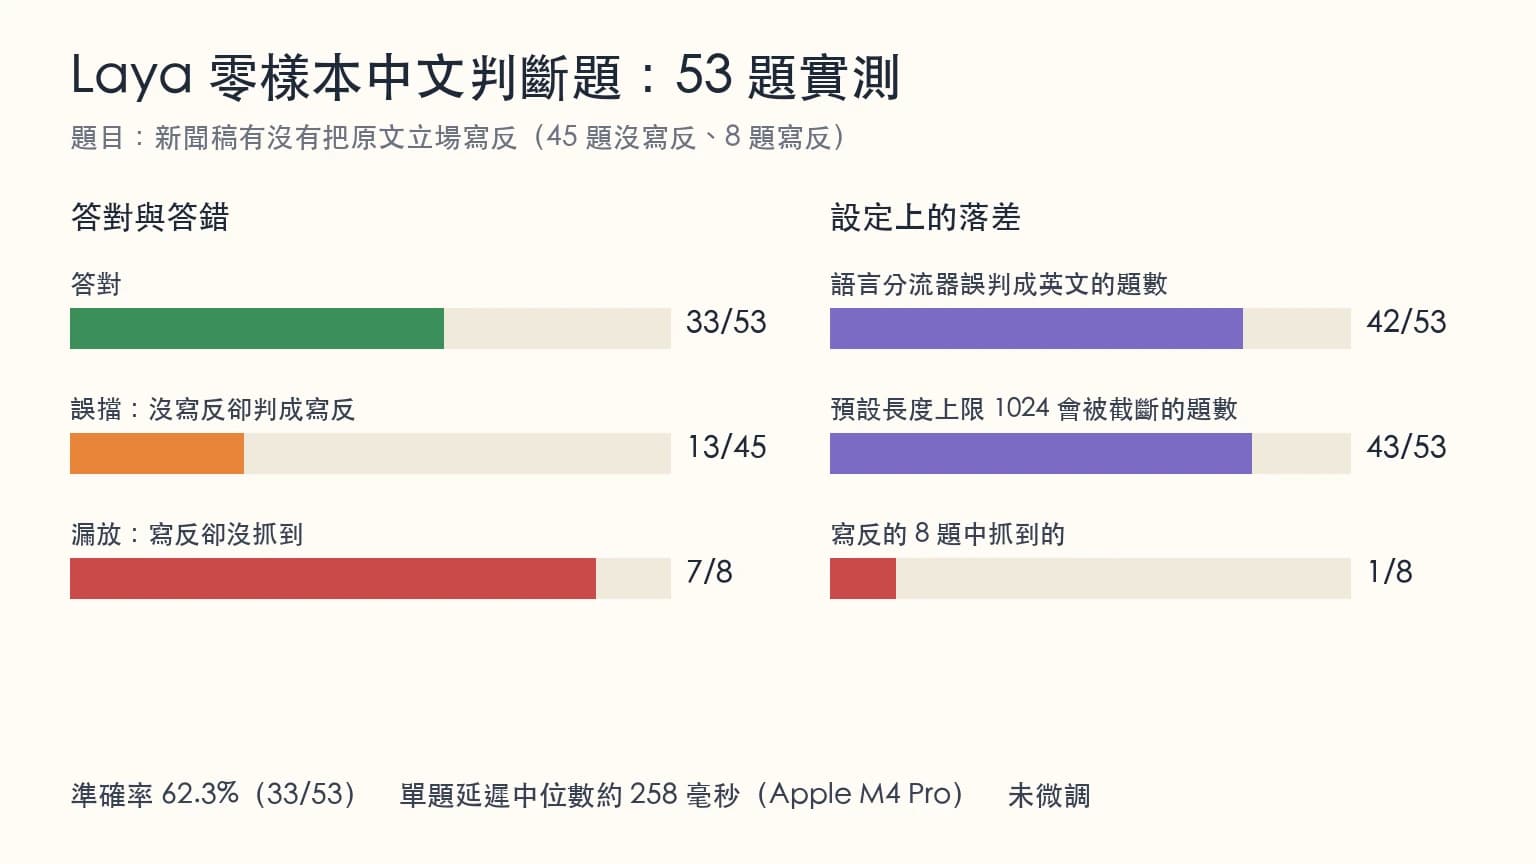
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南
Gradio 部署 AI 工作流程教學:從零開始串接模型並上線實戰指南
想快速將 AI 模型變成可運行的網頁應用?本文提供 Gradio 部署 AI 工作流程教學,涵蓋環境設定、模型串接、雲端部署及最佳實踐,幫助開發者從零開始完成實戰上線。
閱讀指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。