研究突破
幻覺作為軌跡承諾:Transformer 生成中非對稱吸引子動力學的因果證據
Hallucination as Trajectory Commitment: Causal Evidence for Asymmetric Attractor Dynamics in Transformer Generation

arXiv cs.LG · 2026-04-20
摘要
研究團隊通過因果分析發現,語言模型的幻覺現象源於早期軌跡承諾,受非對稱吸引子動力學控制。實驗在 Qwen2.5-1.5B 上證實,44% 的提示會在第一個生成令牌就分化為事實和幻覺軌跡,並通過激活補丁技術揭示特定層的因果不對稱性:注入幻覺激活會破壞正確軌跡(87.5% 成功率),但反向恢復僅 33.3%。這項發現為理解和可能控制模型幻覺提供了新的機制性證據。
研究團隊針對自回歸語言模型中的幻覺現象提出因果證據,指出其本質是由早期軌跡承諾所驅動,並受非對稱吸引子動力學控制。研究團隊採用「同提示分叉」方法,透過重複採樣相同輸入來觀察自發性分歧,從而將軌跡動力學與提示層級的混淆因素隔離開來。
實驗在 Qwen2.5-1.5B 模型上進行,涵蓋 61 個跨越六個類別的提示。結果顯示,27 個提示(佔比 44.3%)在第一個生成令牌處發生分叉,導致事實與幻覺軌跡產生分歧。數據顯示,在步驟 0 時 KL 值為 0,而到了步驟 1 時 KL 值大於 1.0。
透過對 28 個層級進行的激活修補(activation patching)分析,研究揭示了顯著的因果不對稱性。在層級 20 注入幻覺激活會導致正確軌跡在 87.5% 的試驗中受到破壞;反之,反向恢復僅在層級 24 達到 33.3% 的成功率。這兩項數據均顯著高於 10.4% 的基線(p = 0.025)以及 12.5% 的隨機修補控制組。
窗口修補(window patching)的結果進一步顯示,修正錯誤需要持續的多步驟干預,而破壞則不需要。
●開發者:可考慮在推理過程早期階段進行干預來降低幻覺風險,為微調和對齐技術提供新思路
●投資人:幻覺控制技術可成為提升 LLM 可靠性的關鍵差異化因素
●一般用戶:有助於未來開發出更可靠的 AI 助手,減少錯誤資訊的生成
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
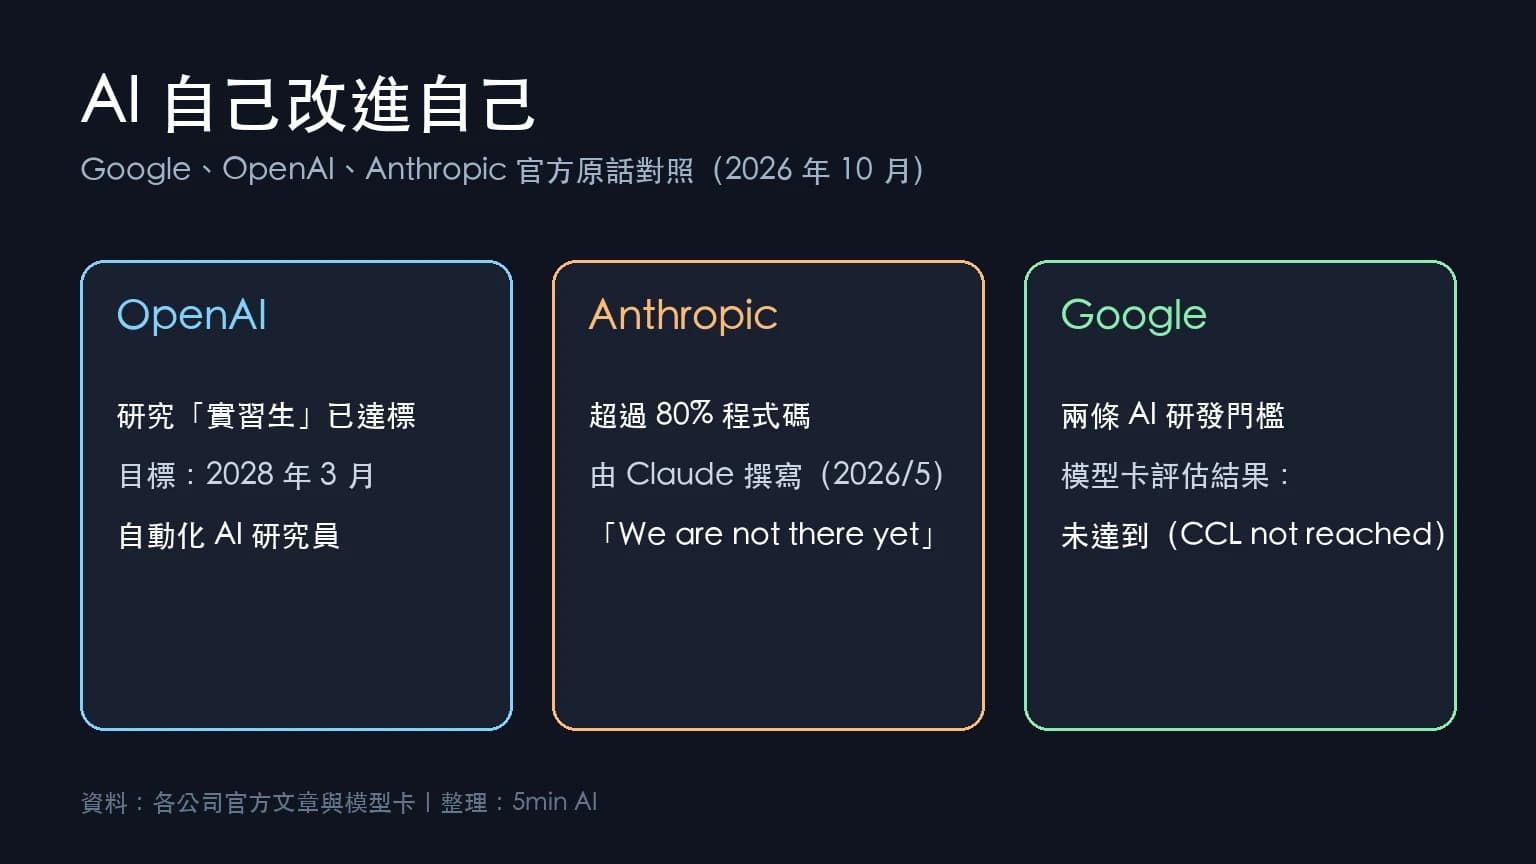
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。