研究突破
BRAID:統一多模態推理的強化學習框架
Bridging Interleaved Multi-Modal Reasoning as a Unified Decision Process

arXiv cs.AI · 2026-07-07
摘要
研究團隊提出 BRAID 框架,將交錯的文本-圖像-文本推理統一為馬可夫決策過程,使強化學習能夠同時優化文本和圖像生成。突破過往只能優化文本步驟的限制,讓策略梯度能夠穿過異質模態的完整軌跡,為統一多模態模型的 RL 應用開啟新可能。
研究團隊提出 BRAID 框架,旨在解決統一多模態模型(Unified Multi-Modal Models, UMMs)在透過強化學習(RL)優化多輪生成時面臨的挑戰。現有方法僅將 RL 應用於文本步驟,而將圖像生成 relegated 至監督代理,導致策略梯度無法在異質模態的完整交錯軌跡中傳播,使得 RL 在 UMMs 中的潛力未被充分開發。
BRAID(Bridging interleaved multi-modal reasoning as a unified Decision process)將多輪文本 - 圖像 - 文本推理重新定義為統一的馬可夫決策過程(MDP)。該框架透過單一原則性的 RL 目標,實現文本與視覺生成的聯合優化。它計算共享的軌道級優勢(trajectory-level advantage),並將其一致地傳播至文本 token 與圖像去噪路徑,使兩者各自透過其模態原生的策略梯度機制進行優化。
為解決長視窗的信用分配問題,BRAID 採用視覺語言模型(VLM)評估器,對每個中間圖像的推理效用進行評分,提供密集的回合級反饋,以在關鍵視覺分支上 sharpen 學習。在空間推理與視覺感知基準上的實驗顯示,BRAID 持續優於各種基線,證實了結合視覺思考指導的統一 MDP formulations 對於有效的多模態推理至關重要。
●開發者:可在多模態模型訓練中應用統一 RL 目標,改進交錯推理能力
●投資人:多模態 AI 生成能力的重要技術突破方向
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →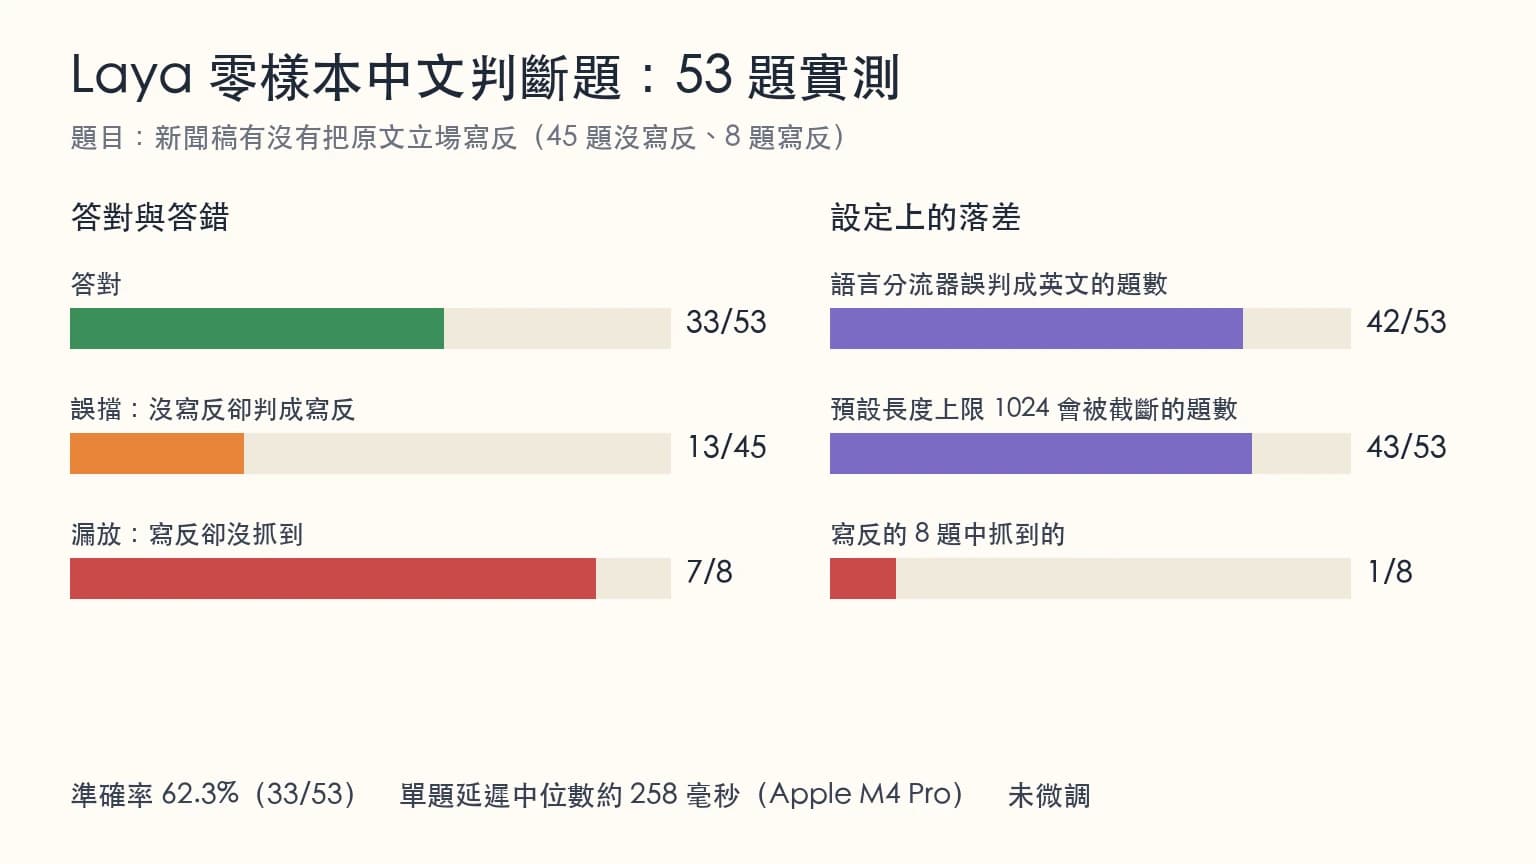
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →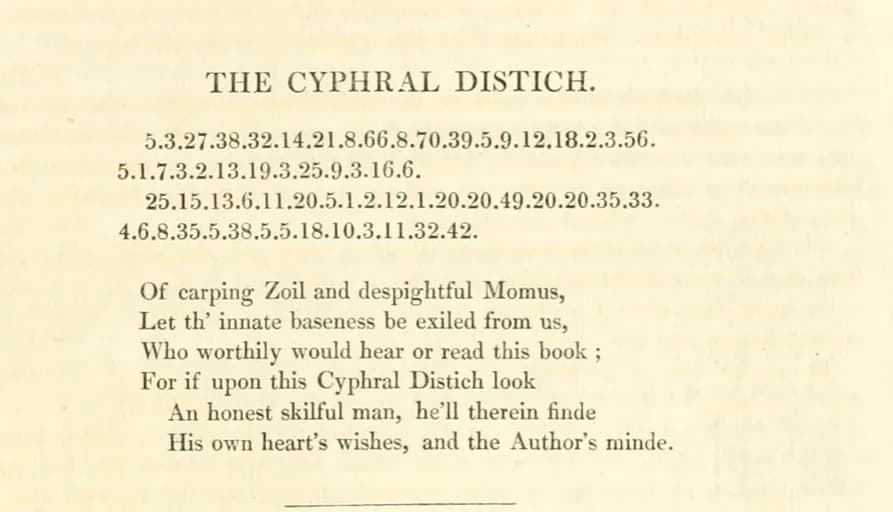
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。