垂直產業
GuideSkill:讓 LLM 執行臨床指南的智能推理層
GuideSkill: Evolving Executable LLM Agent Skills for Guideline-Grounded Clinical Reasoning
arXiv cs.AI2026-07-31
摘要
研究團隊推出 GuideSkill,一個將臨床實踐指南編譯成可執行函數的推理層,讓 LLM 能夠按照診療標準做出決策而非單純檢索文本。GuideSkill-Zero 從指南初始化,GuideSkill-Evo 則通過病例數據優化診斷技能,在四個基準測試中平均準確率比傳統 RAG 方案提升 13.45%,展現 AI 在醫療診斷領域的實際應用潛力。
研究團隊在 arXiv 上發表編號 2607.26160v1 的論文,提出名為 GuideSkill 的系統,旨在解決大型語言模型(LLM)在臨床實踐指南(CPGs)應用上的核心限制。現有系統通常僅檢索指南文本或透過訓練吸收內容,無法執行其規則;GuideSkill 則作為外部推理層,將特定疾病的診斷標準編譯為可執行函數,直接返回序數診斷支持分數。
該系統包含兩個核心組件:GuideSkill-Zero 與 GuideSkill-Evo。GuideSkill-Zero 直接從臨床指南進行初始化,而 GuideSkill-Evo 則利用病例與診斷配對數據來優化已覆蓋的技能並補充缺失的診斷。在推理階段,LLM 提出鑑別診斷,定位每個匹配技能所需的特徵,並將 LLM 的排名與執行技能的分數進行融合。
在四個基準測試與四個後端模型(backbones)的評估中,GuideSkill-Zero 的平均宏平均準確率比傳統基於指南的檢索增強生成(RAG)方案提升了 13.45%。GuideSkill-Evo 則在每個後端模型中均達到最高的宏平均準確率,相對於直接推理提升了 18.49% 的相對值,並將黃金標籤技能覆蓋率從 5 開始提升。
●開發者:可學習如何將結構化規則整合到 LLM 工作流中
●投資人:醫療 AI 診斷輔助工具市場值得關注
●一般用戶:醫療機構可能採用更符合診療指南的 AI 輔助診斷系統
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南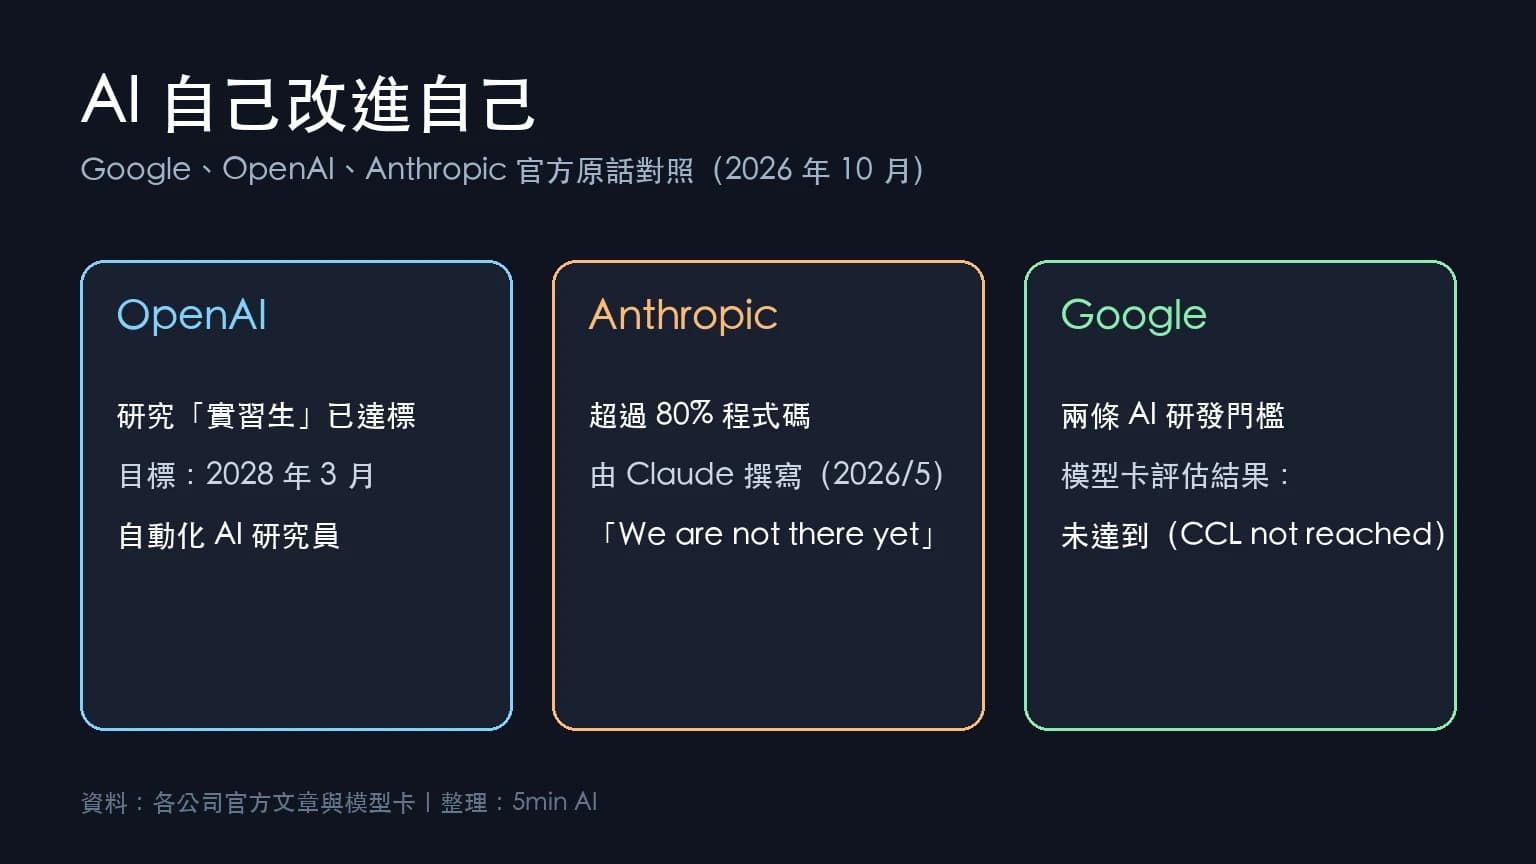
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。