開發工具
Harness Engineering 解析:如何評估、迭代與保護 AI 程式碼代理
The Anatomy of Harness Engineering: How to Evaluate, Iterate, and Guard AI Coding Agents
developers.googleblog.com · 2026-09-26
摘要
Google Developers 提出針對 AI 程式碼代理(AI Coding Agents)的評估方法,指出傳統端到端基準測試(如 SWE-bench)成本高且缺乏根因診斷能力。建議開發者採用行為評估(Behavioral Evaluations),透過快速、本地的單元風格測試來驗證中間動作,從而建立微觀檢查機制,確保在迭代系統提示與升級模型時能避免回歸問題。
傳統基準測試的盲點與高成本
Google Developers 工程師 Taylor Mullen 與 Christian Gunderman 指出,開發者在建構 AI 程式碼代理系統時,常常陷入一個迷思:只依賴 Terminal-Bench 或 DeepSWE 這類端到端基準測試。這些測試雖然是評估模型表現的標準做法,但當綜合分數只是微幅波動時,開發者往往搞不清楚背後的原因。要深入調查這些變化,成本非常高,而且傳統方法也很難給出根因診斷。
多數團隊習慣把 AI 代理當成應試學生,丟給它大型程式碼庫跟時間限制,只用通過測試的數量來論成敗。一旦分數下降,傳統基準沒辦法直接回答關鍵問題:模型是不是對模糊的提示過度自信?是不是漏掉了驗證測試套件?還是幻覺出根本不存在的 CLI 參數?這種黑盒式的最終考試模式,對中間過程完全沒有掌控力。
行為評估:微觀檢查與迭代夥伴
為了解決這個困境,Google 建議採用「行為評估」(Behavioral Evaluations)。這個方法類似軟體開發中的整合測試,用意是驗證代理是否執行了預期的具體行為,而不是只看最終結果。透過建立豐富的行為評估集,開發者可以確立代理行為的基準線,並把它當成迭代時的夥伴,確保在調整系統提示或升級模型時,不會發生功能倒退的狀況。
行為評估聚焦在離散、可觀察的動作上。例如,遇到不明確的提示時,代理會不會主動提問釐清,而不是隨便用猜的?修改建置檔案時,會不會先跑本地驗證器?生成文件時,有沒有附上標準倉庫連結?這些微觀檢查機制就像安全網,讓開發者在迭代系統提示或切換模型時,能立刻發現有沒有不小心破壞核心行為。
開發階段與架構設計
Google 強調,行為評估應該屬於開發的第二階段。在初期,開發者應該依賴直覺跟「吃自己的狗糧」(dogfooding)策略,讓代理處理樣板程式碼、寫 Markdown 渲染器、執行日常任務。等代理具備這樣的能力之後,才引入評估套件——它的主要目的不是為了慶祝效能提升 2%,而是確保新提示、工具架構變更或模型升級,沒有讓整體表現變差。
在架構上,健壯的評估框架會把行為斷言拆分成快速、確定性的單元風格檢查,並在本地執行。這種轉向小規模、可觀察動作的做法,能建立起可靠的防護機制。透過自動化提示工程循環——例如讓大型語言模型自己調整系統提示,直到失敗測試通過為止——同時讓其餘測試套件扮演 CI/CD 風格的防護欄,就能確保變更不會破壞既有功能。
實作策略與自動化監控
建構行為評估套件時,Google 建議從簡單的三步循環開始。第一步,選定單一失敗模式,例如代理忘記在標記任務完成前執行單元測試,把它當作目標。第二步,根據任務複雜度撰寫有彈性的斷言:簡單任務可以用嚴格單輪斷言,檢查特定里程碑;複雜任務則避免強制執行僵化的工具順序,改用比較模糊、結果導向的檢查方式,例如用 LLM 當裁判,評估代理的步驟是否安全解決了問題。
最後,為了監控穩定性,應該自動化批次評估,而不是只依賴單一次運行。因為 AI 模型本身具有非確定性,單一評估可能會產生噪音。透過追蹤隨時間變化的聚合通過率,開發者可以拿到方向性的信號,藉此靈活調整提示、升級模型,不必因為預期內的變異就暫停開發。
宏觀與微觀評估的互補
最終,行為評估不是要取代大型端到端評估套件,而是跟它互補。宏觀基準驗證的是最終目的地,微觀行為評估則扮演夥伴角色,支援安全又快速的迭代。把兩者結合起來,開發者在進行提示變更、開發新功能或部署新模型時,能獲得更高的信心。Google 強調,代理不需要更高的基準分數才能起步,而是需要一個能維持誠實、類似標準軟體單元測試與整合測試的評估框架。
●開發者:可採用行為評估與微觀檢查機制,提升 AI 程式碼代理的迭代穩定性與除錯效率
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
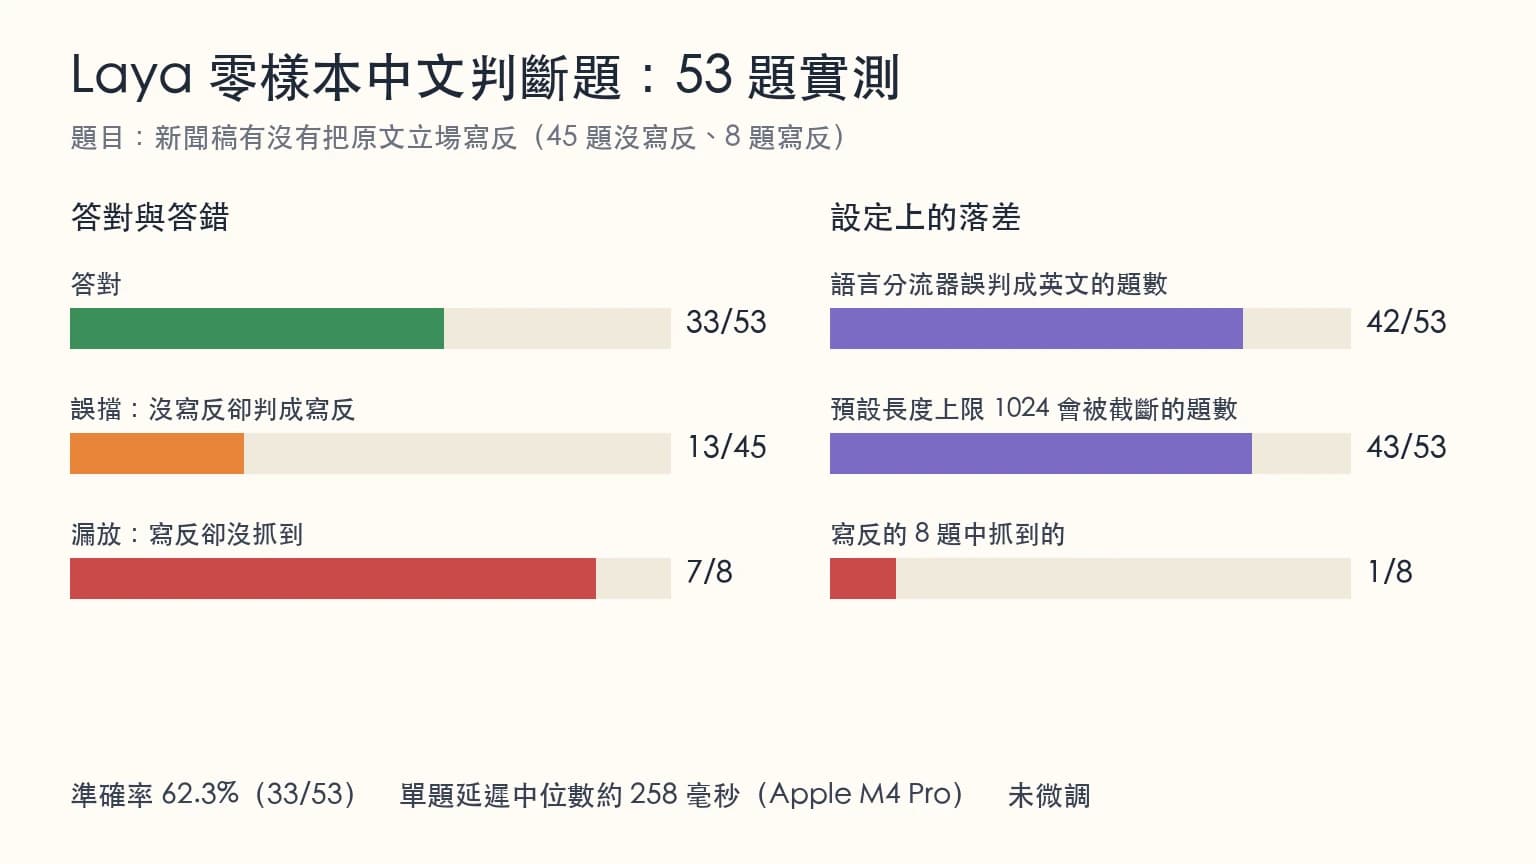
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →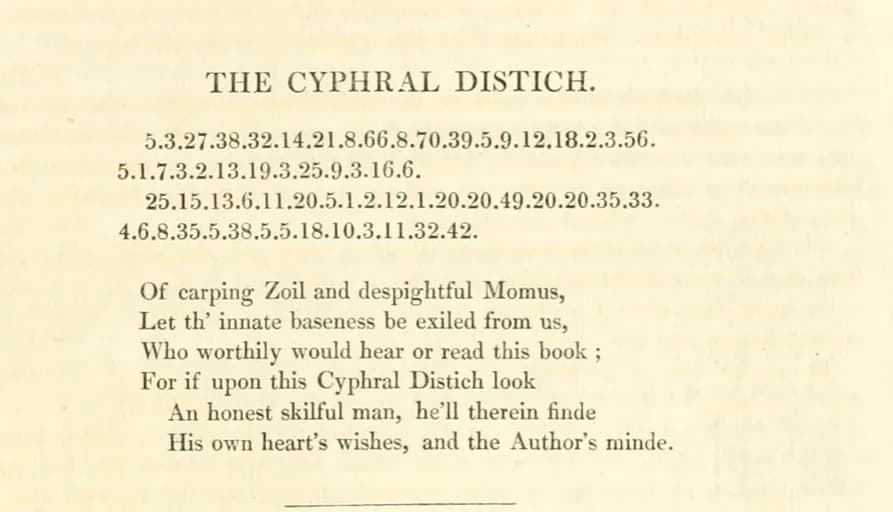
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。