產品發佈
利用 LiteRT 與 Gemma 在 Raspberry Pi 上實現高效 Edge AI
Mastering Edge AI on Raspberry Pi with LiteRT and Gemma
developers.googleblog.com · 2026-09-26
摘要
Google 推出 LiteRT 工具,讓開發者能更輕鬆地在 Raspberry Pi 等邊緣裝置上部署 Gemma 等輕量級開源模型。LiteRT 透過優化 CPU 與 GPU 效能,並支援即將到來的 Hailo AI 加速器,實現快速 token 生成與本地即時推理,大幅簡化了模型轉換、量化與執行的流程。
邊緣運算新突破:LiteRT 與 Gemma 在 Raspberry Pi 的實作
Google 近期推出 LiteRT 工具,協助開發者在 Raspberry Pi 等邊緣裝置上部署 Gemma 等輕量級開源模型。LiteRT 是 Google AI Edge 底下的高效能生產級本機推理執行階段,透過優化 CPU 與 GPU 效能,並支援即將推出的 Hailo AI 加速器,做到快速 token 生成與本地即時推理。這項技術簡化了模型轉換、量化與執行的流程,開發者可以把從傳統機器學習到最新大型語言模型(LLM)部署到各種平台上。
Gemma 模型家族與硬體協同效應
Gemma 是 Google 推出的輕量級開源模型家族,適合用來建構自主代理程式、智慧攝影機及社交機器人。針對不同硬體限制,Gemma 提供多種選項:Gemma 3 270M 是超高效緊湊型基礎模型,適用於情感分析等低延遲任務;Embedding Gemma 300M 用於產生高品質嵌入,支援檢索增強生成(RAG);Gemma 3 1B 是輕量級多語言純文字模型,適合摘要與內容創作;Gemma 4 E2B 專為行動與緊湊邊緣環境設計,具備記憶體映射層嵌入,能節省大量 RAM;Gemma 4 E4B 則在效能與大小間取得平衡,具備較強的推理能力,適合複雜的多步驟規劃。
在 Raspberry Pi 5 上,LiteRT 與 Gemma 的硬體軟體協同效果很明顯。以 Reachy Mini 機器人為例,整套系統能完全在本地即時感知並回應環境,不需要依賴雲端,延遲極低,資料也留在本地保護隱私。
CPU 與 GPU 效能表現分析
透過 LiteRT-LM 這個專門的協調層,開發者可以直接部署 Gemma。在 Raspberry Pi 5 上,LiteRT 用 XNNPACK 做 CPU 加速,確保資源效率與低延遲。以 Gemma 4 E2B 為例,LiteRT-LM 在預填充階段達到每秒 99 個 token,解碼階段為每秒 9 個 token,峰值記憶體佔用僅 1432 MB。由於其 tokenizer 效率高,平均每個 token 約包含 4.2 個字元,換算下來端到端生成速度約為每秒 27.3 個字元,相當於每分鐘 300 字,比人類正常語速(每分鐘 150 字)快上不少。
Raspberry Pi 5 的 quad-core ARM Cortex-A76 CPU 提供約 153.6 GFLOPS(FP32)運算力,Broadcom VideoCore VII GPU 時鐘為 800 MHz,提供約 76.8 GFLOPS(FP32)。雖然 CPU 運算力明顯較高,但 GPU 的平行執行對即時邊緣應用還是很重要。透過 LiteRT 的 WebGPU(Vulkan)後端,開發者可以把視覺或音訊模型卸載到 GPU 上,把 CPU 週期留給系統監控或 LLM 推理用。這套整合支援來自 LiteRT Hugging Face Community 的各種模型,包括 MediaPipe 與 Ultralytics YOLO。
Reachy Mini 平行處理架構
Reachy Mini 這套管道展示了低延遲、即時邊緣 AI 推理的做法。系統把密集的視覺與語言工作負載拆分成 CPU 與 GPU 並行的雙處理架構,流程如下:Ultralytics YOLO 物件偵測在 GPU 上持續運行,避免資源互搶;Moonshine 語音識別在 CPU 上把音訊轉成文字;Gemma 4 E2B 在 CPU 上處理轉錄內容與視覺metadata,產生低延遲串流回應;最後 TTS 在 CPU 上把文字合成音訊串流傳回機器人。
開發工具與未來展望
LiteRT 提供涵蓋轉換、量化、基準測試與推理的完整工具鏈。LiteRT CLI 把核心邊緣工作流程整合成單一命令集,簡化開發流程。開發者可以把 LiteRT CLI 技能加進 AI 編碼代理程式,例如 Google Antigravity,讓它自主執行多階段機器學習工作。對於資源有限的 IoT 裝置,LiteRT 維持輕量且模組化的分發方式,不需要捆綁重型桌面或伺服器相關依賴。
未來,LiteRT 整合與 Gemma 模型會支援 Hailo AI 加速器,可以把模型推理卸載到 Raspberry Pi AI HAT+ 與 AI HAT+ 2 上,透過原本熟悉的 LiteRT 工作流程拿到不少硬體加速效果。開發者可以透過 LiteRT Developer Site 文件、GitHub 儲存庫及 Hugging Face Community 取得資源與模型,開始部署自己的邊緣 AI 應用。
●開發者:可透過 LiteRT CLI 快速在 Raspberry Pi 部署 Gemma 模型並優化效能
●投資人:邊緣 AI 硬體生態系(如 Hailo)與開源模型應用潛力值得關注
●一般用戶:未來可能體驗到更快速、隱私性更高的本地 AI 服務
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Gemma 4 12B 本地運行教學:16GB 筆電實戰部署指南
如何在具備 16GB 記憶體的筆電上本地部署並運行 Google 的 Gemma 4 12B 模型?本文提供完整硬體需求分析與步驟教學,實現音訊影片分析與隱私保護,無需雲端也能跑 AI。
閱讀指南 →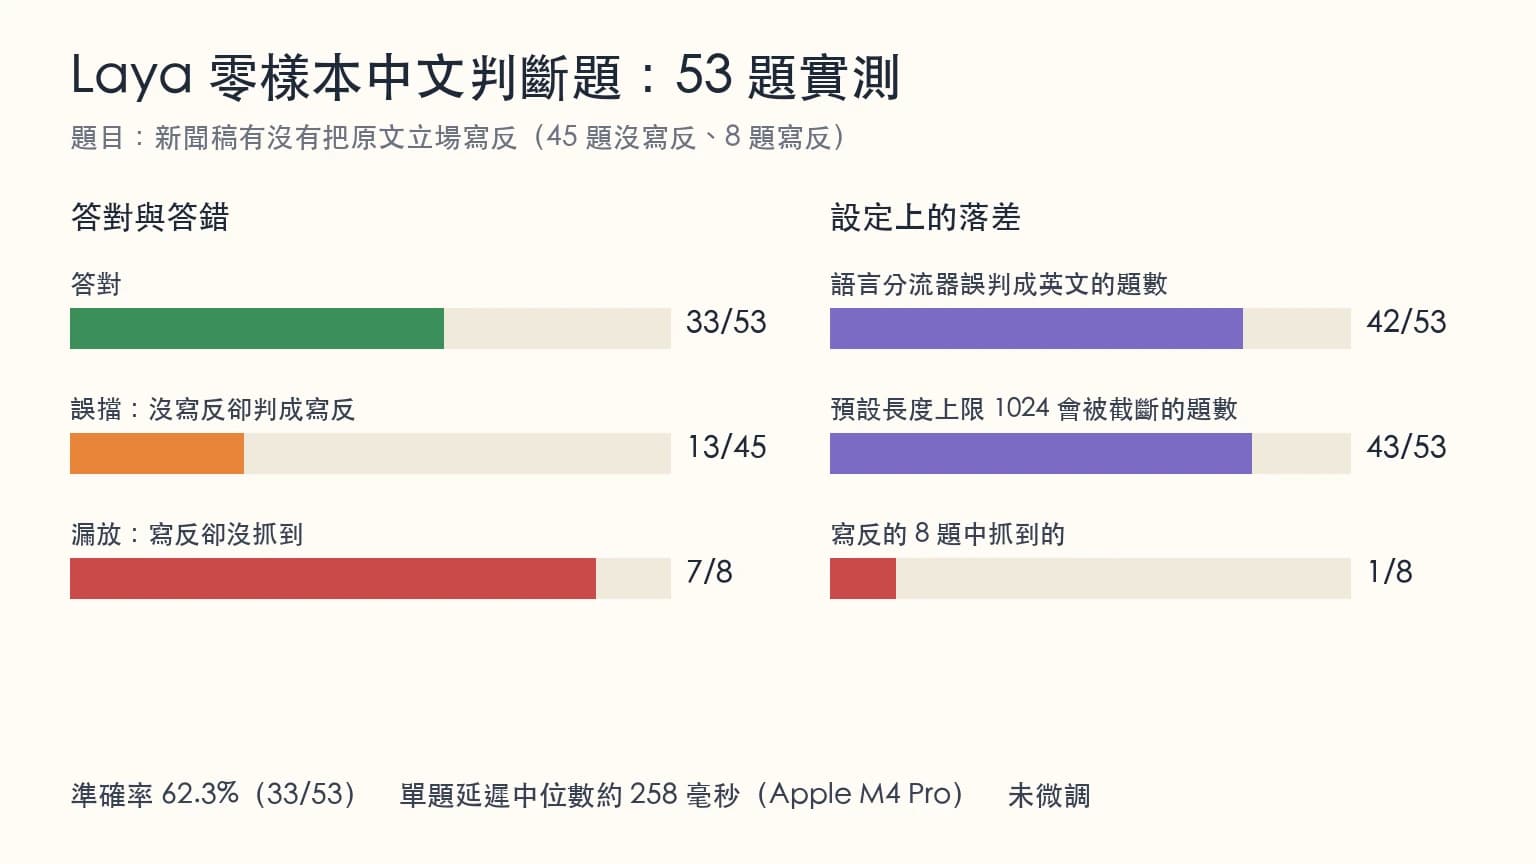
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →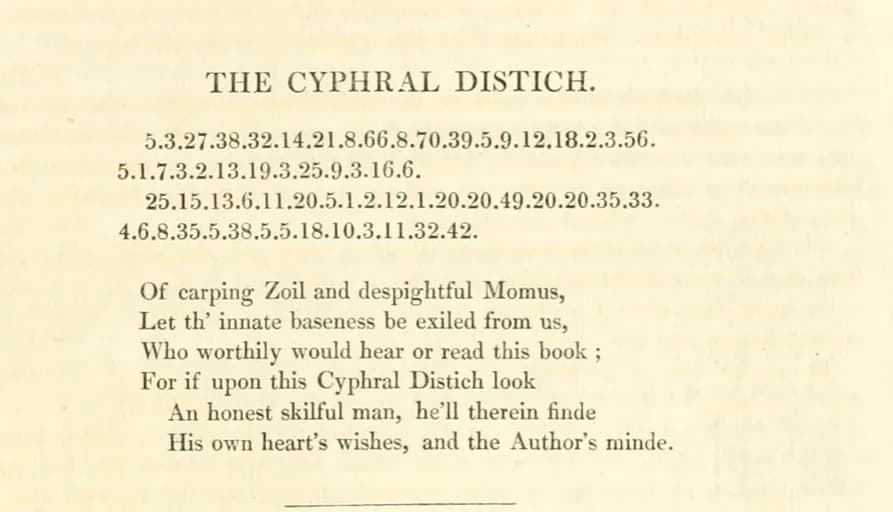
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。