硬體基建
Google Cloud 原生整合 TPU 支援至 vLLM,優化長上下文多模態嵌入推論
Enterprise-Grade Precision for Long-Context Multimodal Embedding Inference on Cloud TPU
Google Developers · 2026-10-01
摘要
Google Cloud 宣布將 TPU 支援原生整合進 vLLM 推論引擎,並透過 Google Kubernetes Engine (GKE) 實現嵌入管線的高彈性擴展。針對 Qwen3-Embedding-8B 等模型處理 15K+ token 長上下文的需求,工程團隊實作了硬體張量對齊、JAX/XLA 編譯預熱及混合 StepPool 架構等 TPU 專屬優化,達成與 GPU 基準近乎完美的數值一致性。開發者可透過 AI-Hypercomputer GitHub 上的開源設定範例,立即建構高吞吐量的語義檢索應用。
Google Cloud 宣布將 TPU 支援原生整合進 vLLM 推論引擎,這項技術突破旨在解決高需求嵌入管線(embedding pipelines)的擴展痛點。透過與 Google Kubernetes Engine (GKE) 的深度結合,開發者現在能夠實現資源的高彈性擴展,確保在負載波動時仍能維持服務穩定性。此整合不僅提升了基礎設施的靈活性,更直接針對大規模語言模型的實際應用場景進行了優化,特別是針對需要處理極長上下文的情境。
在具體的技術挑戰方面,工程團隊重點解決了模型如 Qwen3-Embedding-8B 在處理 15K+ token 長上下文時的效能問題。為了達成這一目標,團隊實作了多項 TPU 專屬的硬體與軟體優化措施。首先是硬體安全張量對齊(hardware-safe tensor alignment),這確保了數據在 TPU 硬體層級的正確傳輸與處理,避免了潛在的記憶體錯誤或效能瓶頸。其次是 JAX/XLA 編譯預熱(JAX/XLA compilation pre-warming),這項技術通過預先編譯計算圖,顯著減少了推論開始前的延遲,提升了整體響應速度。此外,針對分塊預填充(chunked prefill)的管理,團隊引入了混合 StepPool 架構,這種架構能夠更有效地調度計算資源,以應對長上下文帶來的複雜計算需求。
這些技術增強帶來的直接成果是,整合後的系統在數值精確度上達成了與參考 GPU 基準近乎完美的數值一致性(near-perfect numerical parity)。這意味著開發者在遷移或混合使用 TPU 與 GPU 資源時,無需擔心因硬體差異導致的結果偏差,保證了應用邏輯的可靠性。對於希望建構高吞吐量語義檢索應用的開發者而言,Google Cloud 提供了開源的設定範例(setup recipes),這些範例已上傳至 AI-Hypercomputer GitHub 倉庫。開發者可以直接利用這些現成的配置,快速部署並測試其嵌入服務,無需從零開始進行繁瑣的硬體適配與效能調優工作,從而大幅縮短了從開發到生產環境的上線時間。
●開發者:可參考開源設定優化 vLLM 在 TPU 上的效能
●投資人:Google Cloud 強化 AI 基礎設施競爭力
●一般用戶:無直接影響
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →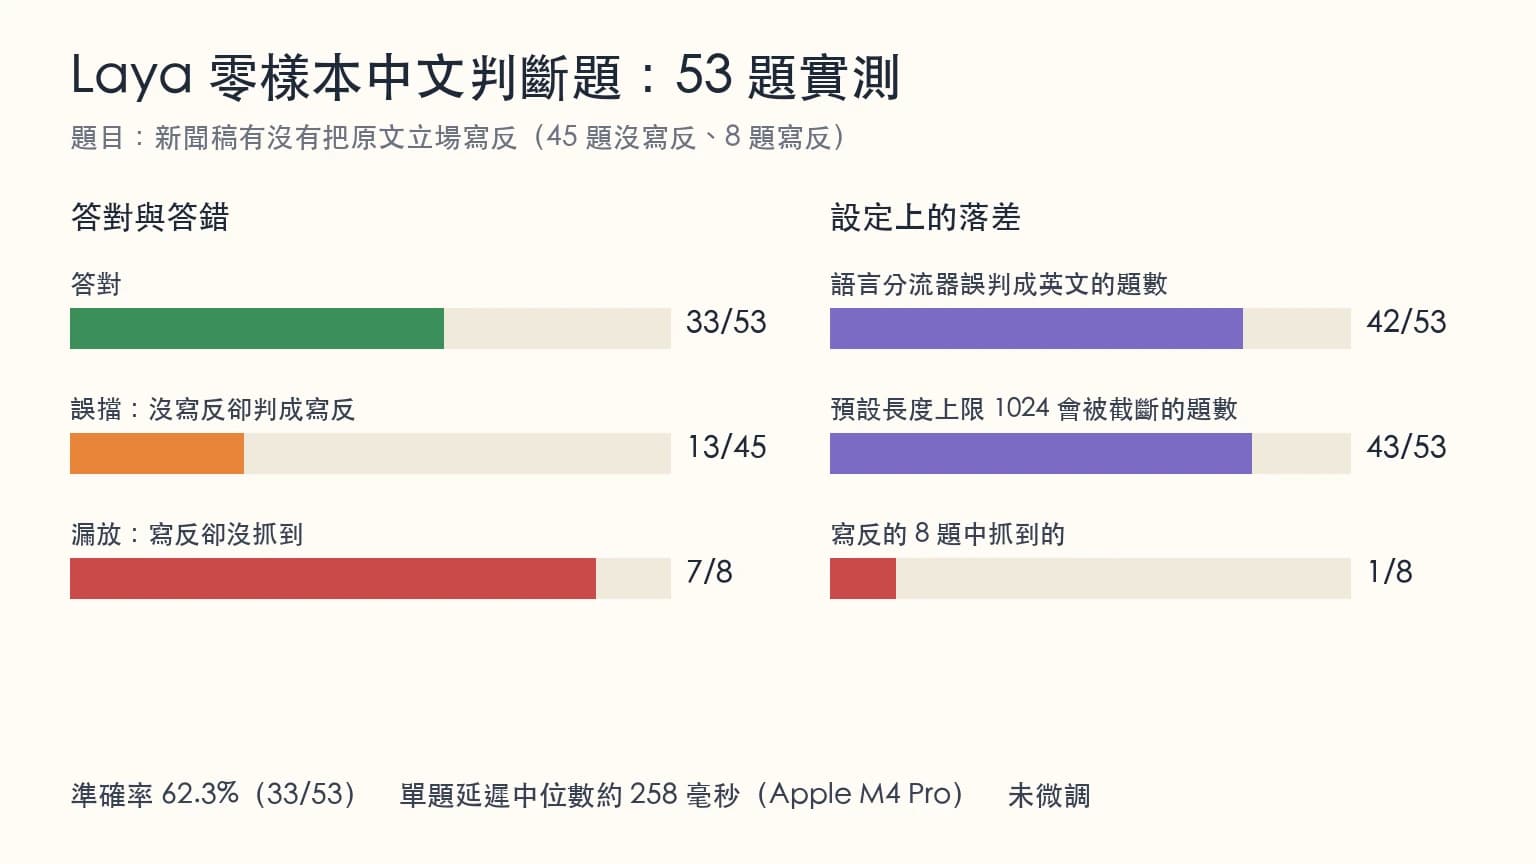
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →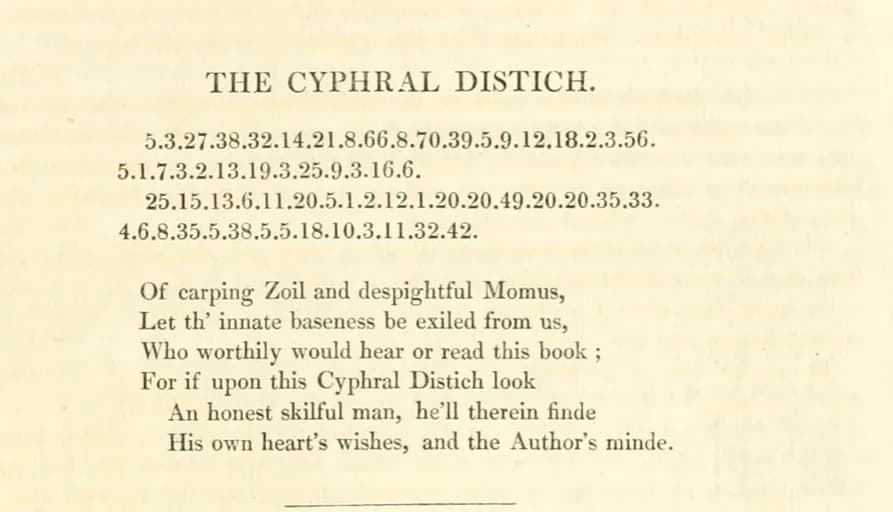
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。