研究突破
研究團隊提出 galahad-kv 技術,將大型語言模型的 ...
Real Long-Term Memory for AI: A 50-Million-Token Window That Is Faster and Cheaper Than Recompute
arxiv.org · 2026-10-09
摘要
研究團隊提出 galahad-kv 技術,將大型語言模型的 KV 狀態加密存儲於本地 NVMe 硬碟,實現高達 5000 萬 token 的長上下文檢索。在 Gemma 4 模型與 NVIDIA H100 的測試中,該方法不僅檢索速度比重新計算快 2.8 至 4.3 倍,能耗更低,且能準確回憶極早期植入的資訊,為突破上下文窗口限制提供了高效方案。
突破上下文限制:Galahad-KV 實現五千萬 Token 長程記憶
Corbenic AI 研究團隊發表名為 galahad-kv 的技術,目的是解決大型語言模型在處理極長文本時的限制。該技術將模型計算出的鍵值(KV)狀態加密存儲於本地 NVMe 硬碟,而非僅限於顯存。這項創新使得模型能夠檢索高達 5000 萬 token 的長上下文,且無需重新計算,同時保持 GPU 記憶體使用量恆定。
技術架構與實作方式
galahad-kv 作為公開套件(版本 1.31.4),透過 GalahadConnector 插件整合至 vLLM 0.31.0 推理伺服器。其核心機制分為「存入」與「恢復」兩個階段。在存入階段,系統將每約 16,000 token 的 KV 狀態寫入採用 AES-256-GCM 加密的本地磁碟儲存區,格式標頭為 MRLNCRY1,隨後釋放對應的 GPU 記憶體。在恢復階段,當需要特定歷史區塊時,系統會將加密的 KV 狀態 graft 回模型,使前向傳播繼續進行,彷彿模型剛計算過該區塊,且完全不涉及 token 的重新計算。
這種設計創造了一個「移動視窗」,同一時間僅有一個區塊 resident 於顯存中,其餘區塊皆存於磁碟。因此,無論處理多少 token,GPU 記憶體使用量始終保持平穩,不會隨上下文長度增加而膨脹。
實驗設置與硬體環境
測試環境使用單張 NVIDIA H100 80 GB 顯卡與本地 NVMe 儲存設備。軟體堆疊包含 galahad-kv、vLLM、transformers 及 nvidia-ml-py,皆為公開軟體。測試模型為 Gemma 4 12B(bf16)與 Gemma 4 31B(FP8),兩者皆使用各自的 tokenizer。
語料庫總計 50,000,000 token,由 WildChat(40%)、開源程式碼(25%)、arXiv 論文(20%)及教育網頁文本(15%)組成。為確保測試嚴謹性,研究團隊實施了防作弊協議,包括在攝入前以執行期變異器將真實來源中的姓名、日期、金額與電子郵件替換為隨機 nonce 以消除預訓練污染、盲式吸入數據、植入高熵值針刺記錄及誘餌記錄,並審計磁碟上的加密標頭以驗證數據完整性。
效能表現:速度與能耗優勢
實驗結果顯示,galahad-kv 在恢復速度與能耗上顯著優於重新計算。對於 Gemma 4 12B 模型,恢復區塊的中位時間為 0.266 秒,能耗為 59 焦耳;相比之下,重新計算需 0.760 秒及 521 焦耳。這意味著恢復速度提升 2.8 倍,能耗降低 8.8 倍。
對於更大的 Gemma 4 31B 模型,恢復時間為 0.347 秒,能耗 80 焦耳;重新計算則需 1.475 秒及 976 焦耳。恢復速度提升 4.25 倍,能耗降低 12.3 倍。值得注意的是,恢復時間不隨深度增加而增長,即使檢索 5000 萬 token 前的區塊,速度與檢索第一個區塊相同。
準確性與記憶體足跡
在準確性測試中,研究團隊在 5000 萬 token 語料中植入了 100 個針刺記錄。Gemma 4 12B 模型正確回答了 82/100 個問題,Gemma 4 31B 模型則正確回答了 98/100 個問題。兩款模型均未產生幻覺,且在負面對照組中拒絕了不存在的記錄,證明模型是基於恢復的上下文而非編造答案。
關於記憶體足跡,由於 Gemma 4 使用滑動視窗注意力機制,12B 模型的每 token KV 足跡為 36.4 KiB,總儲存需求為 1.86 TB。31B FP8 模型每 token 足跡為 134 KiB,總需求為 6.25 TB。審計確認所有 3,125 個區塊均完整存儲,無遺漏或淘汰。
長期記憶與快取的區別
研究團隊強調,此技術應被視為「長期記憶」而非傳統快取。傳統快取是短暫的,且在未命中時需從源頭重建。galahad-kv 的儲存區具有持久性,重啟後數據依然存在;具有私密性,因每個區塊在靜態儲存時皆經加密;具有字節精確性,確保計算重現;且能超越原生上下文視窗,讓模型利用數百萬 token 前的知識。
此技術不擴大單次注意力視窗,也不涉及學習式檢索。它僅提供 KV 重用,將處理過的內容從磁碟恢復,而非全部保留在顯存中。這使得推理成本更低、速度更快,並讓模型能基於更廣泛的歷史事實進行回應,而不改變模型權重。
●開發者:可透過 galahad-kv 套件在 vLLM 環境中實現低成本長上下文處理
●投資人:關注降低 AI 推理成本與硬體依賴的基礎設施創新
●一般用戶:未來 AI 服務有望具備更強大的長期記憶與連續對話能力
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Gemma 4 12B 本地運行教學:16GB 筆電實戰部署指南
如何在具備 16GB 記憶體的筆電上本地部署並運行 Google 的 Gemma 4 12B 模型?本文提供完整硬體需求分析與步驟教學,實現音訊影片分析與隱私保護,無需雲端也能跑 AI。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →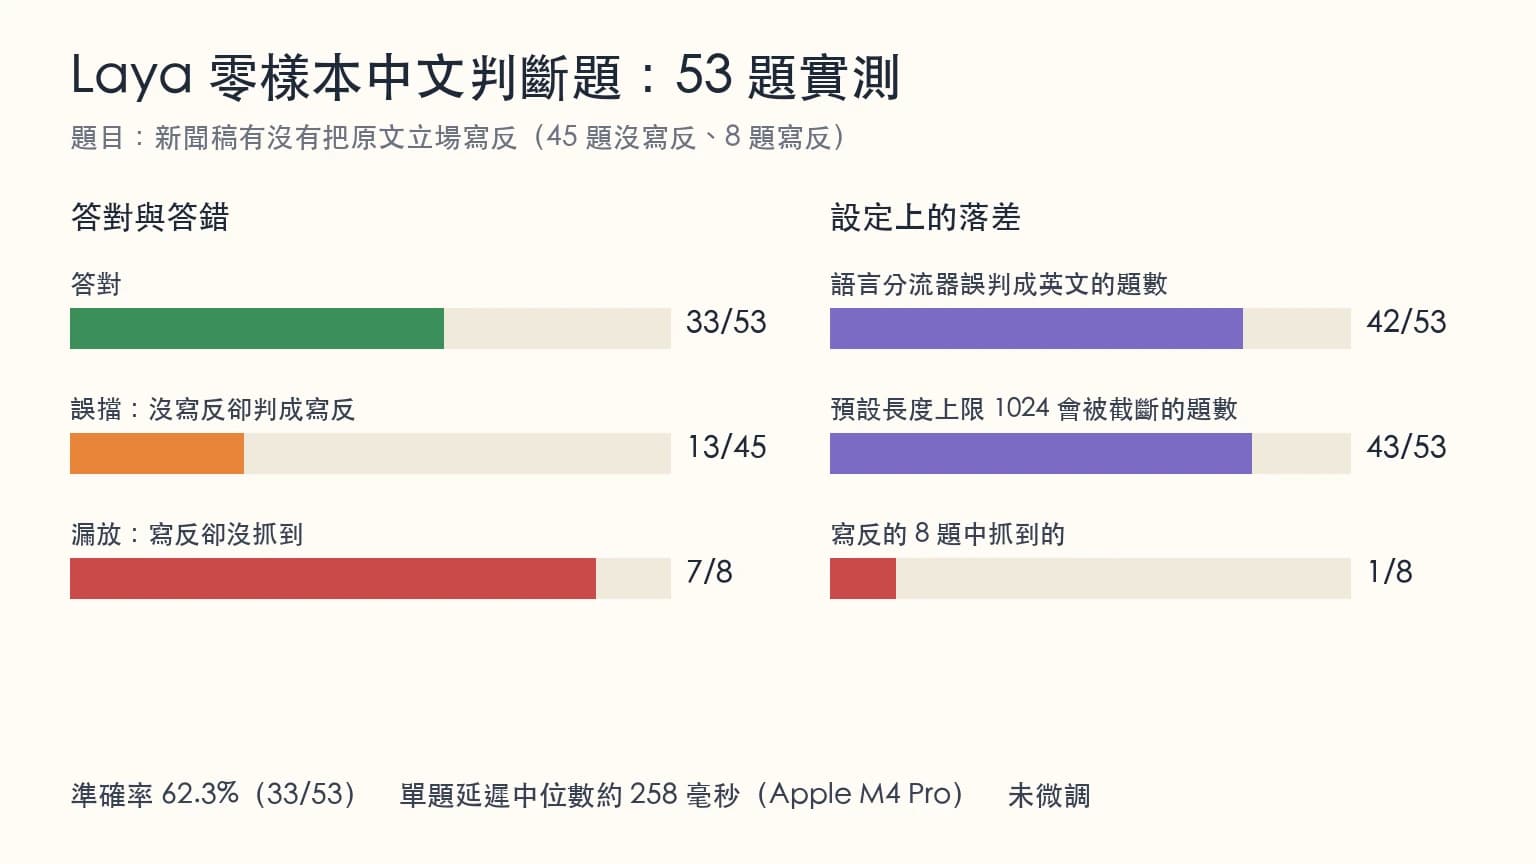
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。