產品發佈
Comfy-Org 推出 MOSS-Image 模型整合包,支援 ComfyUI 部署
Comfy-Org/MOSS-Image
Hugging Face · 2026-10-16
摘要
Comfy-Org 發布了 MOSS-Image 的重新打包模型檔案,專為 ComfyUI 使用者設計。此整合包包含經過優化的影像基礎與 SFT 模型,並整合了 Qwen3.5 文字編碼器與 Flux2 VAE,讓開發者能更輕鬆地在 ComfyUI 環境中部署與測試 MOSS 系列影像生成能力。
Comfy-Org 發布專為 ComfyUI 環境設計的 MOSS-image 重新打包模型檔案,簡化 MOSS 系列影像生成能力的部署流程。此整合包由 OpenMOSS-Team 維護的 MOSS-Image-Base 與 MOSS-Image-SFT 倉庫衍生,整合 Qwen3.5 文字編碼器與 Flux2 VAE,降低 ComfyUI 使用者的技術門檻。
使用者需將檔案依類別分置於 ComfyUI 目錄下的 models 資料夾。diffusion_models 資料夾內提供四種格式與精度的模型檔案:基礎模型包含 moss_image_base_bf16.safetensors 與 moss_image_base_int8_convrot.safetensors;SFT 模型則包含 moss_image_sft_bf16.safetensors 與 moss_image_sft_int8_convrot.safetensors。這些檔案支援 bf16 精度以及 int8_convrot 量化格式,以滿足不同的效能與記憶體需求。
text_encoders 資料夾整合 Qwen3.5 系列模型,提供 qwen3.5_9b_w4a8_gptq.safetensors 與 qwen3.5_9b_int8_convrot.safetensors 兩個檔案。
●開發者:可快速部署 MOSS 影像模型於 ComfyUI
●投資人:關注開源影像模型生態系的工具鏈完善度
●一般用戶:未來可能透過支援 ComfyUI 的介面體驗更強大的影像生成
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
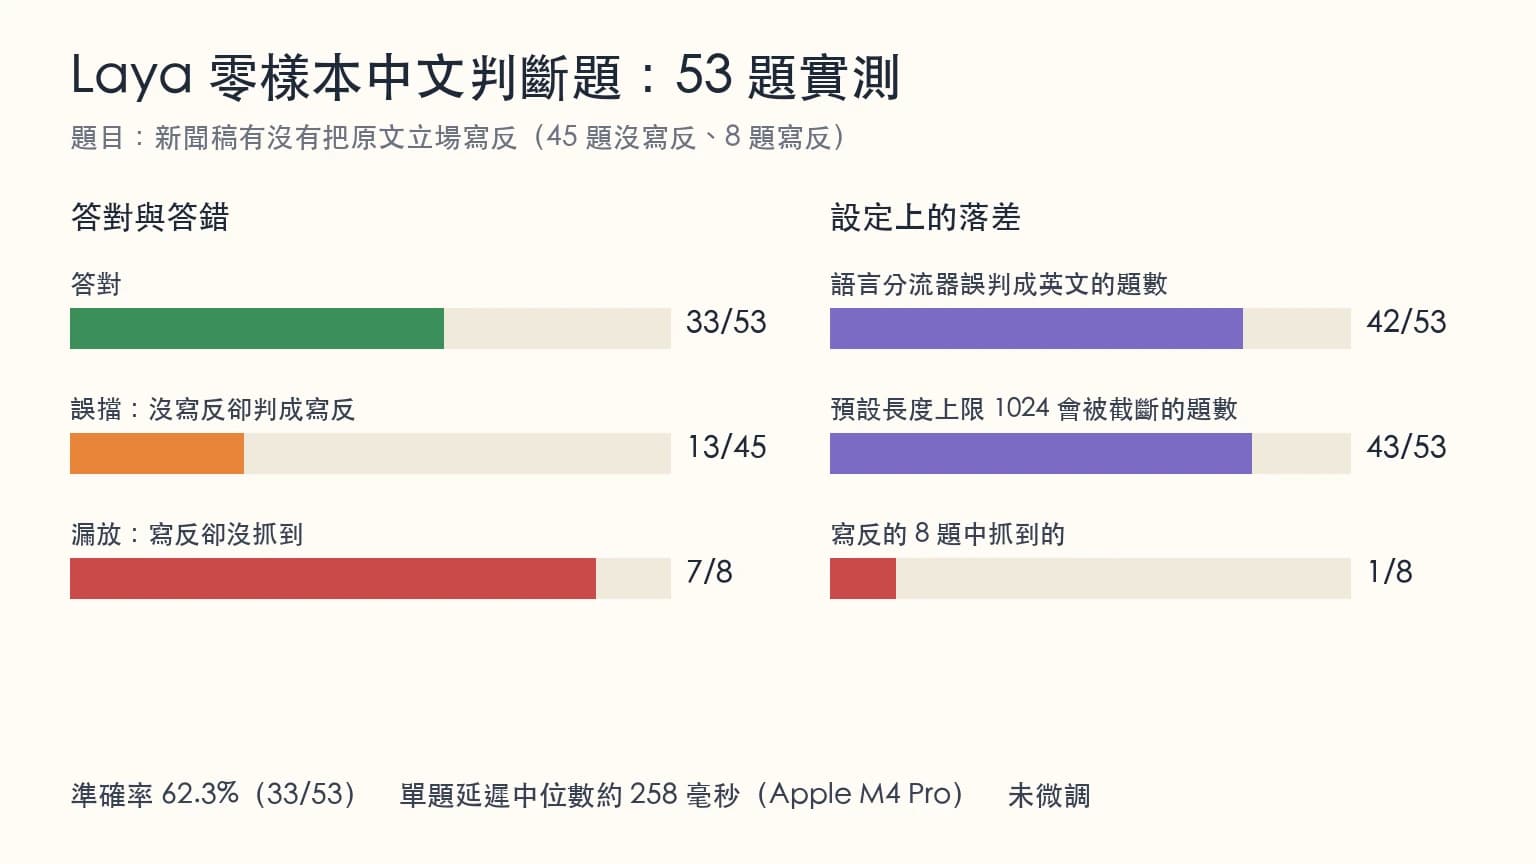
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →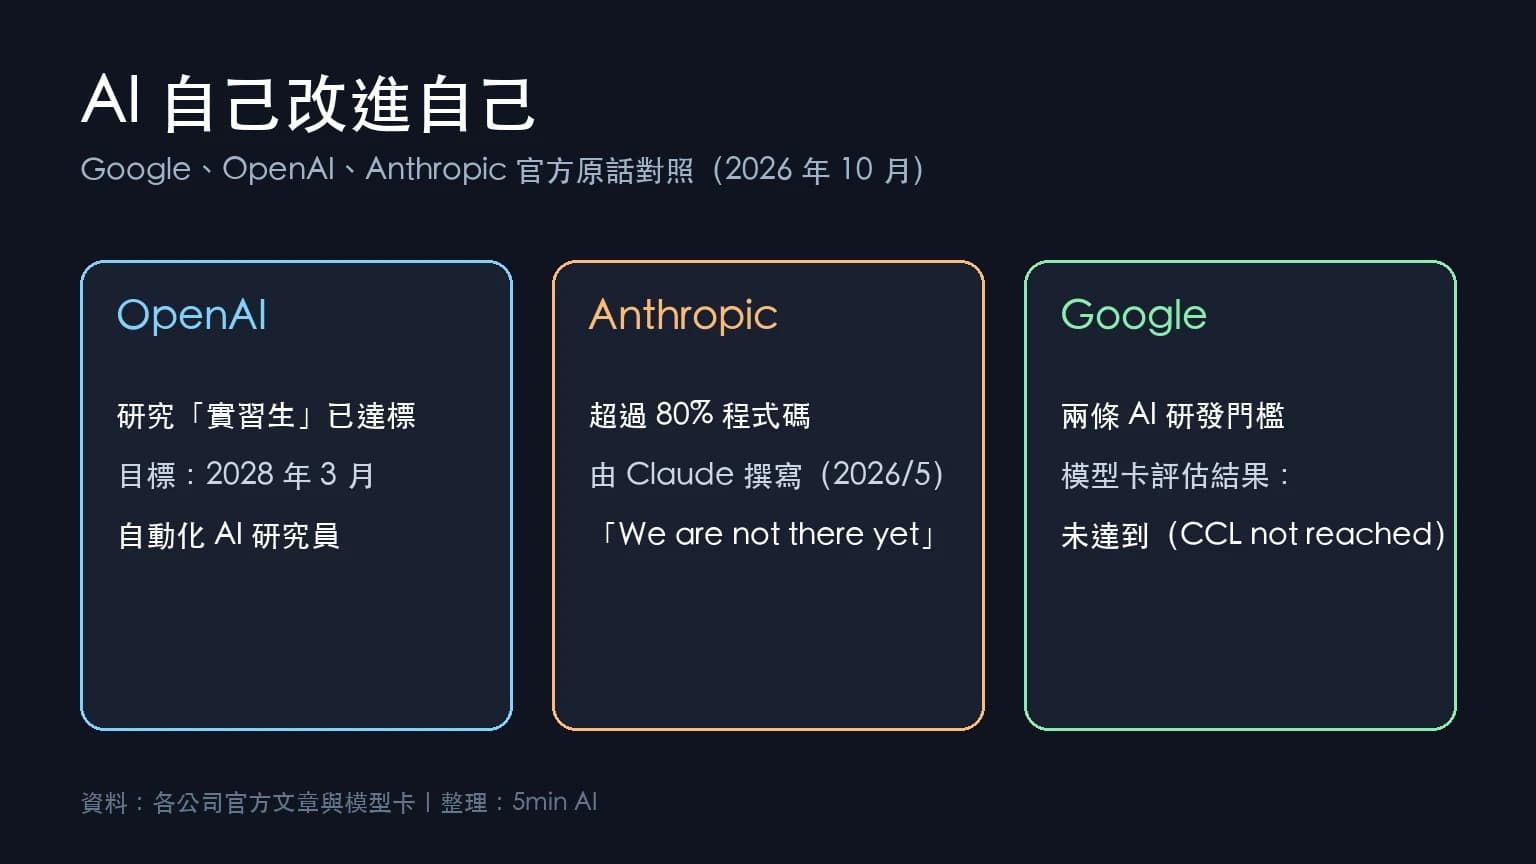
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。