開發工具
The Outer Loop, Insights First: 一款能診斷生產環境 Agent 品質的 Ambient Quality Agent
The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent
developers.googleblog.com · 2026-10-19
摘要
Google Developers 開源了 AQuA (Ambient Quality Agent),這是一款參考實作,旨在解決 AI Agent 上線後難以監控品質退化的問題。該工具部署在 Google Cloud 上,能自動掃描並驗證失敗案例,並根據確切的程式碼快照診斷根本原因,幫助開發者在 Agent 服務真實流量時持續優化。
解決生產環境 Agent 品質隱憂:Google 開源 AQuA
Google Developers 在 2026 年 10 月 8 日開源 Ambient Quality Agent(簡稱 AQuA)。這是部署在 Google Cloud 上的參考實作工具,要解決的是 AI Agent 上線後,品質退化很難監控的問題。它會自動掃描生產環境中的失敗案例,再根據確切的程式碼快照診斷根本原因,讓開發者能在真實流量下持續優化 Agent 服務。
生產環境的「第二個 20%」挑戰
把 Agent 開發到能處理預設測試案例的「前 80%」階段,相對來說很快。但上線後要維持品質,難度高得多。使用者發現 Agent 的實際能力後,使用模式會跟著偏移,即時流量就不再符合最初的評估集。另外,模型升級或工具更新這類底層變動,雖然能通過基礎健康檢查,卻可能讓對話品質與任務成功率出現變化,而標準部署流程根本不會預警。
會話出錯時,開發者得先分辨故障出在哪一層:模型可能產生幻覺或遺失約束;編排框架可能路由錯誤或遺失狀態;工具合約可能因文件缺失而拒絕輸入;指令裡也可能缺少未預期的規則。這些故障模式的責任歸屬和修復方式各不相同,只看原始軌跡記錄釐清不了因果,必須把失敗軌跡和部署時的程式碼快照放在一起分析。
AQuA 的五階段自動化診斷流程
AQuA 以非同步方式在 Google Cloud 專案中運行,定期從 Cloud Trace、Cloud Logging 或 BigQuery 抽取生產軌跡,不介入請求路徑,也不會寫回 Agent。核心流程分成五個階段:
1. 抽樣:隨機抽取最多 1,000 筆近期會話,控制運行成本。 2. 審查:依據九點檢查清單(涵蓋程序、工具選擇、接地、任務完成等)替會話評分。若判定失敗,就記錄結構化的實際與預期差異。 3. 聚類:把失敗機制相同的發現歸為候選問題聚類。 4. 驗證:由獨立模型檢查每個候選聚類,並根據最多三筆完整會話,剔除證據不足的假陽性。 5. 追蹤:將剩下的聚類與 BigQuery 中的已知洞察比對,標記為 NEW、RECURRING,或在 14 天未見後自動標為 RESOLVED。
開發者可以撰寫 `goal.md` 來引導審查方向,並搭配確定性的 Python 自訂指標做趨勢分析。預設使用單次會話審查法官以節省成本,也可以選擇啟用 Gemini 平台的受管理軌跡 AutoRaters 做標準化評分。
實戰案例:Travel-Concierge 的缺陷修復
在 `google/adk-recipes` 的 travel-concierge 案例中,AQuA 掃描 32 筆會話,產生 42 筆結構化發現,並聚類為 9 個候選問題。驗證後排除 3 個假陽性,留下 6 個已驗證問題,主要包含:
* 跳過座位可用性檢查:15 筆會話中,`planning_agent` 在用戶自報座位時,沒有呼叫 `flight_seat_selection_agent` 就直接儲存狀態。 * 跨子代理遺失飲食限制:7 筆會話中,`inspiration_agent` 的純素偏好沒有傳給 `place_agent`,結果推薦了牛排。 * 提示與工具集矛盾:5 筆會話中,`poi_agent` 的提示要求驗證欄位,但工具列表是空的,結果生成了佔位符 URL。
透過 Dashboard 觸發根因分析後,AQuA 把缺陷定位到 `planning/prompt.py` 第 93 行和 `inspiration/prompt.py` 第 23 行,並提出錨定在程式碼快照上的修復建議。套用修復並部署 Revision 2 後,座位選擇跳過率下降 87%,純素遺漏降到 0,完整會話通過率從 5/32 提升到 13/32。
成本效益與未來展望
AQuA 的設計重視可驗證性與成本可控。驗證階段最多檢查 50 個聚類,每個聚類最多三筆會話。單 Agent 掃描的成本約為每會話 0.007 美元,多 Agent 案例約為每會話 0.12 美元。根因分析只在需要時觸發,每次調查成本介於 0.33 至 2.47 美元。
未來的發展方向包括:整合多種信號來識別靜默失敗、把驗證過的失敗聚類轉成沙盒測試案例,以及探索跨多個 Agent 的無支架附著能力。開發者可以透過 `agents-cli` 指令把 AQuA 整合到現有專案,也能用 `make demo` 在本地以合成數據測試,一起打造生產環境 Agent 品質的持續優化流程。
●開發者:可關注 AQuA 開源工具,用於監控生產環境 Agent 的品質退化與根因診斷
●投資人:Google 持續強化其雲端 AI 開發者生態系與工具鏈
●一般用戶:此為後端開發工具,對一般用戶無直接影響
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
AI Agent 是什麼?怎麼用?2026 白話文入門完整說明
AI Agent 是什麼?跟普通 ChatGPT 有何不同?本文用白話文解釋 AI 代理人的概念、怎麼讓 AI 自主完成多步驟任務,以及 2026 年最實用的 AI Agent 應用場景。
閱讀指南 →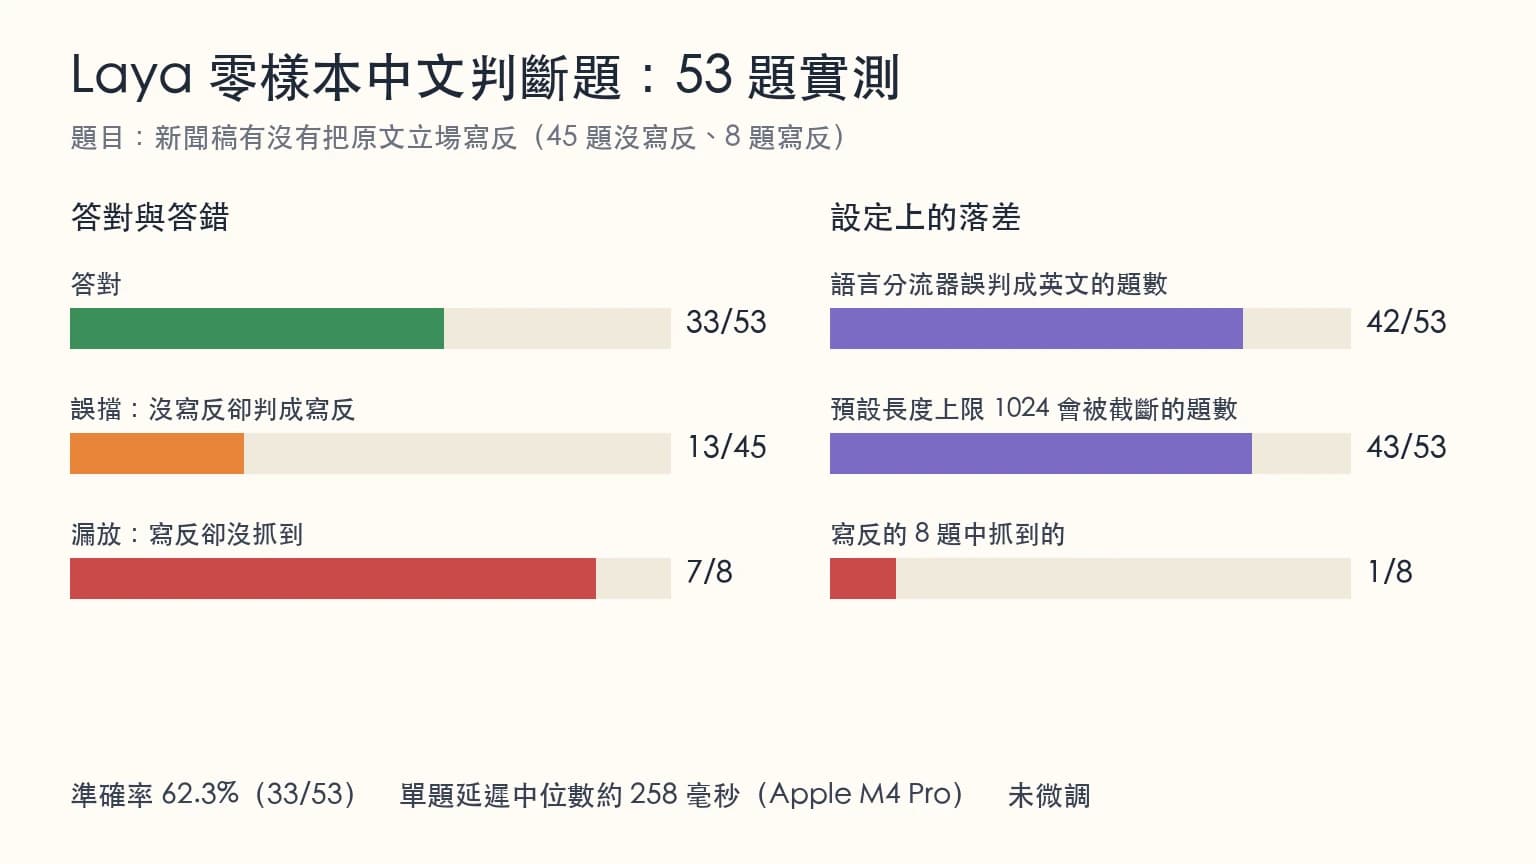
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →
OpenHome3D 實測:一張戶型圖真的能秒變 3D 家居場景嗎?五句網傳宣稱逐一驗證
我們實際跑過 OpenHome3D 的平面圖辨識與 Codex 寫實重繪,逐句驗證「一張圖變3D」「337件家具」「必收」等網傳宣稱,附辨識誤差與家具組成的完整數字。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。