安全倫理
研究揭示:LLM 存在根本性漏洞,無法完全防止駭客攻擊
A fundamental flaw leaves LLMs strikingly vulnerable to attack

MIT Tech Review · 2026-07-30
摘要
MIT 科技評論報導,國際機器學習大會上發表的研究指出,大語言模型因其工作原理存在根本性缺陷,無法做到完全安全防護。這項發現對 LLM 技術的安全性有重大影響,意味著即使採用最先進的防護措施,仍可能存在無法消除的安全隱患。
●開發者:需重新評估 LLM 應用的安全架構設計
●投資人:AI 安全方案和防禦技術可能成為新的投資機會
●一般用戶:在使用 LLM 服務時應提高警惕,避免輸入敏感資訊
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
2026 AI 漏洞掃描工具推薦:Codex Security 與 Claude 實戰評測與比較
想知道哪些 AI 漏洞掃描工具最強大?本文深度評測 Codex Security 與 Claude 的實戰表現,對比自動修復漏洞的效能,提供開發者與企業選型的完整指南。
閱讀指南 →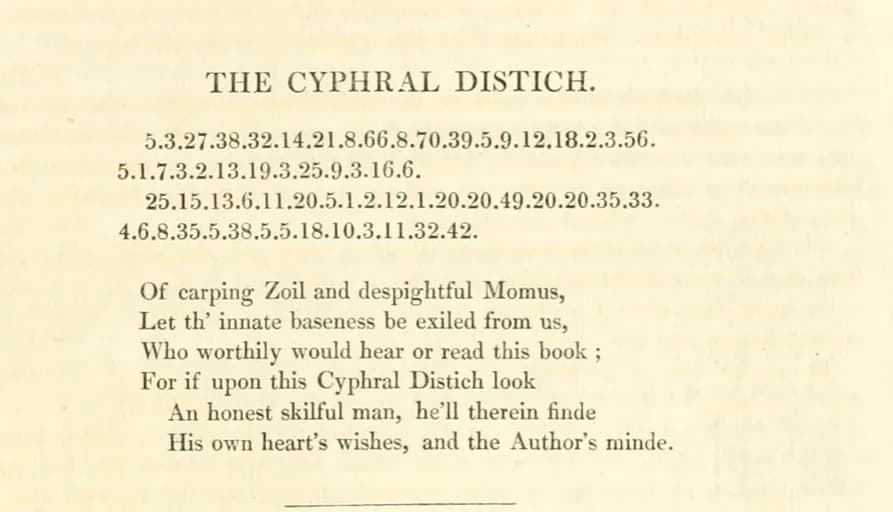
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。