研究突破
AREX-2:透過長程反思任務推進自我改進型 AI 代理
AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
arxiv.org · 2026-10-01
摘要
研究團隊提出 AREX-2,旨在提升 LLM 代理在測試階段自我改進的能力,核心機制結合了產生更優解的「反思」與維持多輪迭代效果的「長程執行」。該模型基於 Qwen3.8-27B 訓練,在 MLE-bench Lite 與 Frontier-CS 等基準測試中表現優異,並成功轉移應用於深度研究任務,展現出跨領域的泛化潛力。
北京智源研究院推出 AREX-2:強化 AI 代理的自我改進能力
北京智源研究院(BAAI)研究團隊發表 AREX-2 模型,目標是提升大型語言模型(LLM)代理在測試階段的自我改進能力。這裡的自我改進,指的是代理在測試時透過反覆迭代來精煉解決方案。這項技術結合兩種互補的能力:一是「反思」,也就是產生比當前方案更好的解法;二是「長程執行」,確保多輪迭代過程中改進持續有效。研究團隊假設這兩種能力屬於不限領域的元技能,因此可以在適合監督學習的場景中訓練,再應用到其他領域。
基於 Qwen3.8-27B 的訓練與數據構建
AREX-2 以 Qwen3.8-27B 架構訓練。為了讓模型學會長程反思,團隊建構了涵蓋機器學習工程與演算法程式設計任務的長程改進軌跡數據。選擇這兩個領域,是因為它們能提供明確的反饋機制,例如驗證分數或裁判判決,也允許解決方案在多個回合中持續優化。數據建構分三個步驟:首先,由教師模型把 GitHub 存儲庫和線上裁判的原始材料轉成可執行的環境;其次,代理在這些環境中進行多輪迭代,依反饋修正方案;最後,團隊以整體軌跡為單位篩選,保留最終分數高且符合任務要求的軌跡,即使其中包含失敗的嘗試或倒退也一併保留,藉此教模型如何從挫折中恢復。
基準測試表現
在機器學習與程式設計領域的基準測試中,AREX-2 取得領先成績。在 MLE-bench Lite 測試中,該模型得到 81.8 分,是所有比較系統中的最高分;在 Frontier-CS 測試中得到 70.7 分,是開放權重模型中的最佳表現。這些結果顯示,AREX-2 只有 27B 參數,性能已能匹敵或超越許多參數量更大的模型。
跨領域泛化至深度研究任務
除了訓練領域,AREX-2 在深度研究任務中也展現泛化潛力。雖然深度研究方面沒有新增訓練數據,模型仍成功轉移應用,並在多項基準測試中超越前代 AREX 模型。具體成績為:BrowseComp 84.0 分、HLE 52.6 分、GAIA 92.2 分、DeepSearchQA 93.8 分。這顯示長程反思數據能有效促進代理在跨領域任務中的自我改進能力。
測試時間擴展與持續改進
研究進一步驗證了 AREX-2 在測試時間擴展上的優勢。在 Frontier-CS 任務中,隨著回合預算增加,模型表現持續提升,在最後一小時內仍有明顯增益。即使沒有外部正確性反饋,AREX-2 也能靠內部判斷持續搜索與精煉答案,每回合的增益約為前代模型的三倍。階段性消融實驗顯示,操作知識、模型訓練以及更大的回合預算,對最終性能都有顯著貢獻,證實長程反思作為元技能的有效性。
●開發者:可參考其自我改進與長程執行的架構設計
●投資人:關注具備自我優化能力的 AI 代理技術發展
●一般用戶:未來 AI 助手可能具備更強的自主解決複雜問題能力
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Qwen vs Kimi vs DeepSeek 2026 比較:亞洲主流模型功能與定價分析
深入分析 2026 年 Qwen vs Kimi vs DeepSeek 三大亞洲主流模型。涵蓋功能對比、長文本處理、定價方案及實戰教學,助您選擇最適合的 AI 工具。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →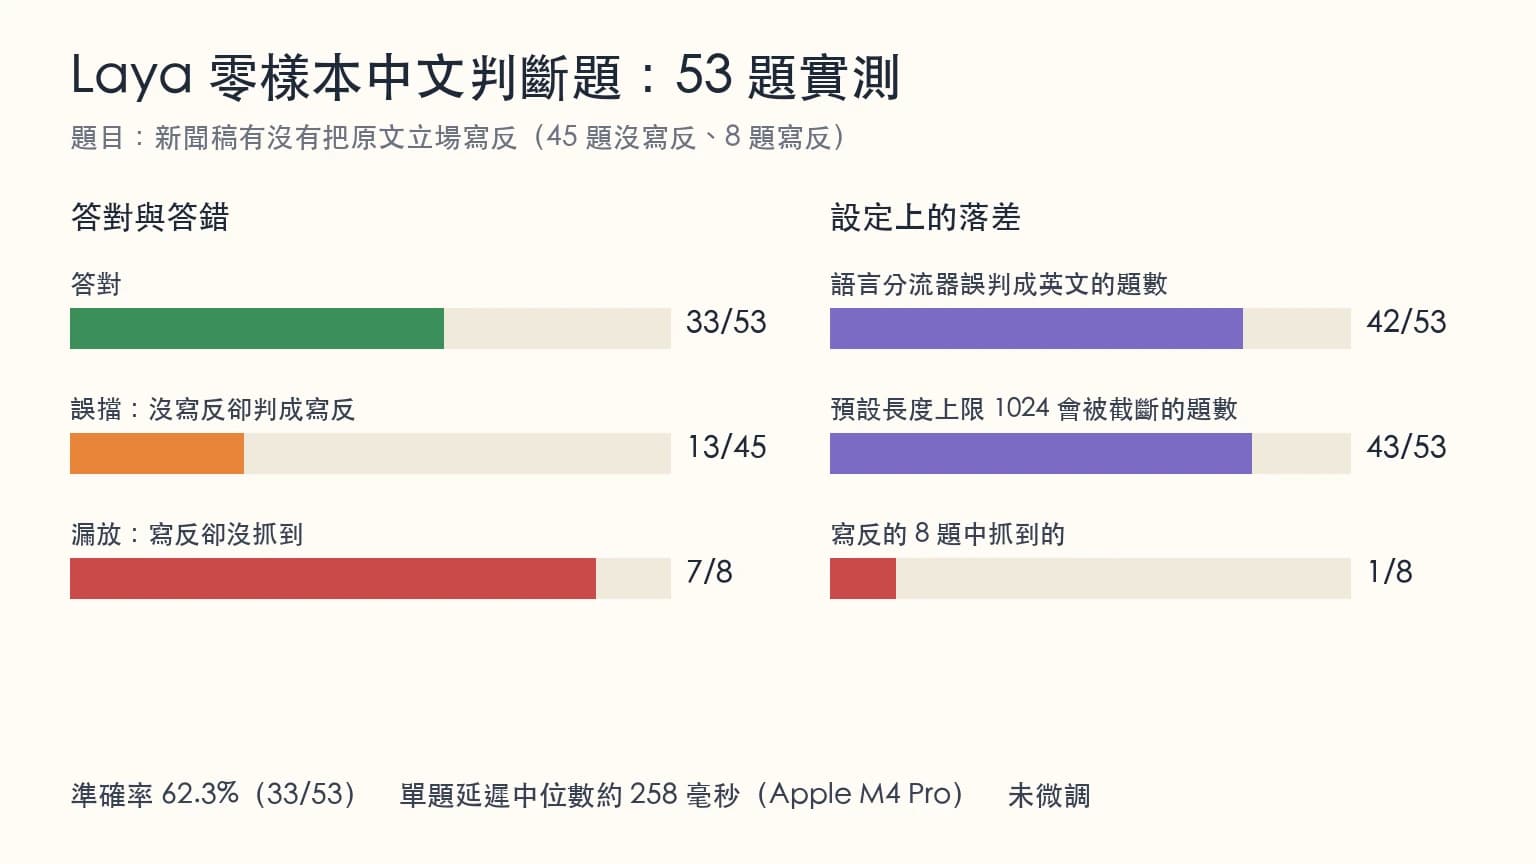
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。