研究突破
AI 攻克隱藏資訊經典遊戲 Stratego,Ataraxos 擊敗人類最強選手
With most information hidden, the game Stratego had stumped AI—until now
arxiv.org · 2026-10-01
摘要
卡內基美隆、MIT 等大學研究團隊開發出 AI Ataraxos,在經典遊戲 Stratego 中以 15 勝 1 敗 4 和的成績擊敗被譽為最強的人類選手 Pim Niemeijer。這項突破解決了長期以來因大量隱藏資訊而難以被 AI 破解的 imperfect-information game 難題,且僅需 16 張 GPU 與數千美元即可完成訓練。
突破隱藏資訊難題,Ataraxos 以極低成本擊敗人類最強選手
卡內基美隆大學、麻省理工學院(MIT)與史丹福大學等機構的研究團隊,開發出名為 Ataraxos 的人工智慧系統,在經典戰略遊戲《戰棋》(Stratego)中展現出超越人類的實力。該系統在一場 20 局的系列賽中,以 15 勝、4 和、1 敗擊敗被譽為史上最強的人類選手 Pim Niemeijer。這項成果解決了長期以來因大量隱藏資訊而難以被 AI 破解的「不完全資訊遊戲」難題,而且訓練成本只要數千美元,遠低於過往耗資數百萬美元的專案。
效能與成本的大幅落差
《戰棋》是一款類似軍事象棋的棋盤遊戲,最大特徵是雙方玩家要秘密排列棋子,對手看不到己方棋子的真實身份。這種大量隱藏資訊的機制,讓傳統依賴完全資訊的演算法(如國際象棋或圍棋所用的方法)無法直接套用。過去有研究團隊投入數年時間與數百萬美元運算資源,仍無法讓 AI 達到頂尖人類玩家的水平,《戰棋》因此可能是唯一一個這類投入龐大資源的嘗試卻未能產生超人類表現的經典遊戲。
Ataraxos 改變了這個局面。研究團隊指出,該系統不僅達到超人類水準,還把訓練成本大幅降到數千美元。這要歸功於自我對弈強化學習與測試時間搜尋(test-time search)技術上的創新。研究團隊強調,這些創新相當簡潔且通用,意味著在許多需要戰略決策的場景中,用適度的運算成本打造超人類決策系統已經可行。
技術架構:雙重 Transformer 與動態阻尼學習
Ataraxos 的核心架構建立在「白板」自我對弈強化學習與測試時間搜尋之上。關鍵創新在於協調正則化強度、策略更新幅度與策略強度之間的互動關係。策略較弱時,系統採用強正則化與激進更新;策略增強後,則轉為弱正則化與微小更新。這個機制能抑制不完全資訊造成的學習動態不穩定,讓策略持續改進。
系統包含兩個獨立的自我對弈過程,分別處理遊戲的兩個階段:棋子佈陣階段與移動階段。為此,Ataraxos 使用兩個 Transformer 架構:設定網路(Setup Network)與移動網路(Move Network)。設定網路採用僅解碼器結構,以自回歸方式生成棋子佈局;移動網路採用僅編碼器結構,負責選擇要移動的棋子與目標位置。
訓練時,Ataraxos 採用動態阻尼自我對弈強化學習。系統引入最大熵項與反向 KL 懲罰項來正則化網路損失,並依訓練進程以不同的冪律調整這些係數。這種方法類似能量儲備:退火太保守會讓模型的棋力發展不足,退火太激進則雖然初期進步快,卻會使模型的熵崩塌、耗盡後續學習的能力。此外,系統透過反向 KL 懲罰、重要性比率裁剪、梯度範數裁剪及 Adam 學習率調度等四種機制控制更新大小,維持學習過程穩定。
測試時間搜尋與高效能模擬器
為了提升決策品質,Ataraxos 在每次移動前都會執行測試時間搜尋。這需要訓練一個信念網路(Belief Network),目標是最大化隱藏棋子在最終自我對弈策略軌跡上的對數似然。信念網路用 Transformer 編碼器處理已知資訊,再用解碼器以行主序解碼未知棋子的類型。訓練期間,系統對信念網路應用 Dropout 技術,以增強它對不同對手策略的泛化能力。
搜尋階段,Ataraxos 先用信念網路根據當前位置採樣出可能的遊戲狀態集合。針對每個候選移動,系統從這些狀態執行深度受限的模擬(rollouts),並以平均網路價值預測評估該移動的價值。接著,系統使用磁鏡下降法(magnetic mirror descent)的表格步驟更新策略,這個更新與訓練時一樣以反向 KL 散度正則化,但允許比訓練期間更激進的更新,因為測試時間的更新是基於更準確的優勢估計。
為了實現這套複雜流程,研究團隊用 CUDA C++ 實作了 GPU 加速的《戰棋》模擬器,在 Nvidia Hopper H100 GPU 上可維持每秒約 1,000 萬次狀態更新。系統把重放緩衝區功能直接整合進 GPU resident 模擬器,省去昂貴的 CPU-GPU 資料傳輸,並採用 bfloat16 資料類型與參數指數移動平均,進一步提升訓練效率。
實戰評估與未來展望
2025 年 7 月,研究團隊在線上平台 Strategus 上安排 Ataraxos 與 Pim Niemeijer 對決。Pim Niemeijer 拿過 4 次世界冠軍、15 次荷蘭全國冠軍,並有超過 600 週排名第一的紀錄,被視為《戰棋》史上最強選手。系列賽共 20 局,歷時 3 週,目的是減少隨機性帶來的變異,也讓 Pim 有機會尋找 AI 的弱點。最終,Ataraxos 以 85% 的有效勝率(和局計為半勝)獲勝,這樣的差距在頂尖人類對決中極為罕見。
2025 年 8 月的《戰棋》世界錦標賽演示中,與會者有機會與 Ataraxos 對弈。在 40 局對弈中,Ataraxos 取得 38 勝 2 負、有效勝率 95% 的成績,進一步證實它面對不同風格的玩家都能取勝。
Ataraxos 的成果顯示,強化學習與搜尋的結合已能克服大量隱藏資訊的障礙,也為許多需要快速、準確模擬器的戰略決策問題提供了實用的 AI 解決方案。研究團隊計劃開源其 GPU 加速模擬器,供社群在這個具挑戰性的基準測試上繼續研究。
●開發者:可關注 imperfect-information game 的演算法突破與低成本訓練方案
●投資人:AI 在複雜策略遊戲領域的技術里程碑值得留意
●一般用戶:經典棋類遊戲可能迎來更強大的 AI 對手
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →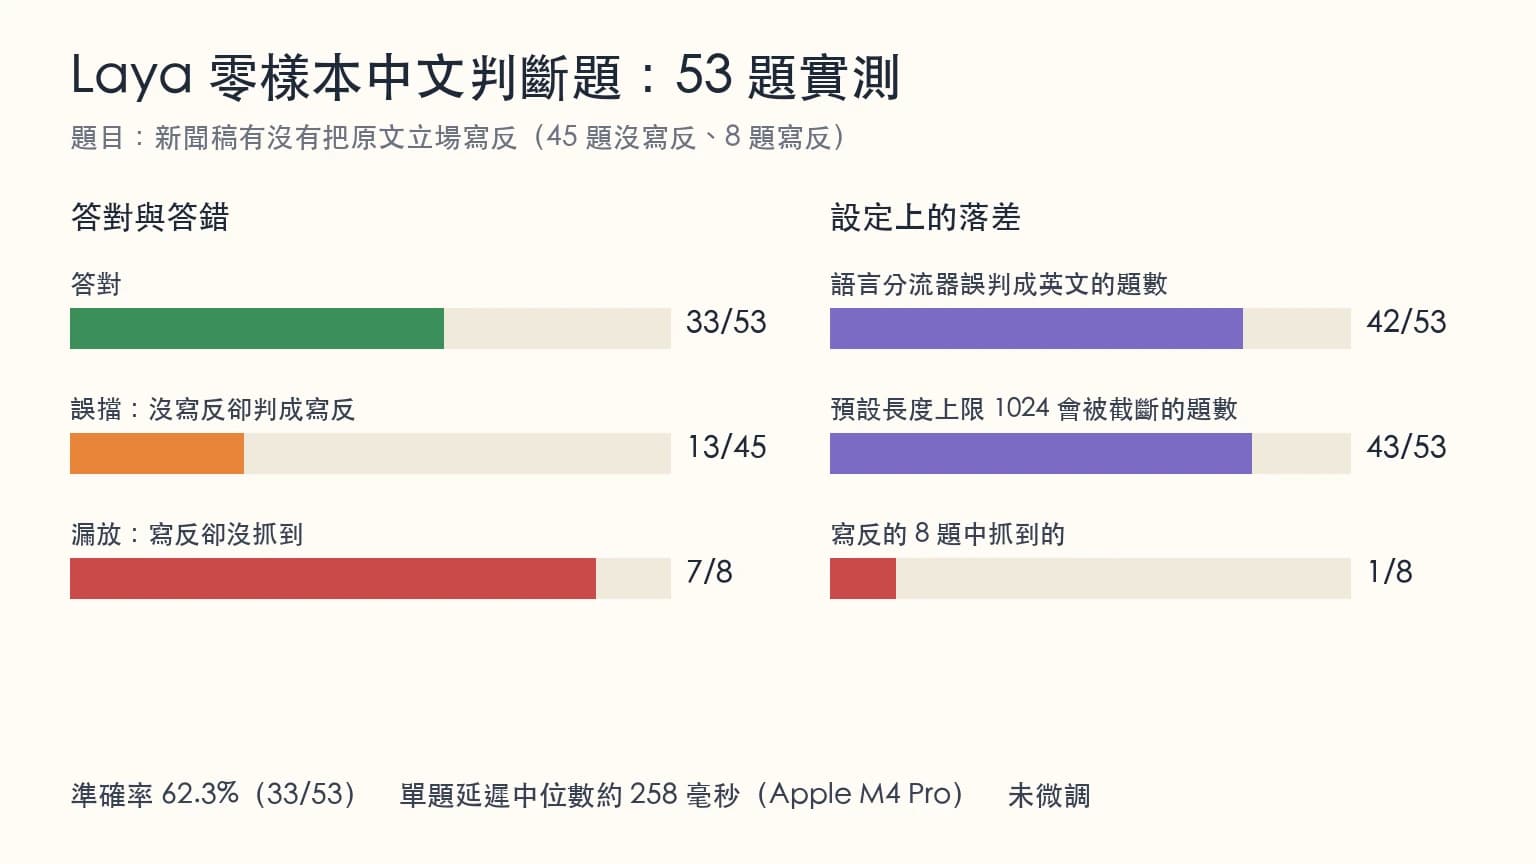
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →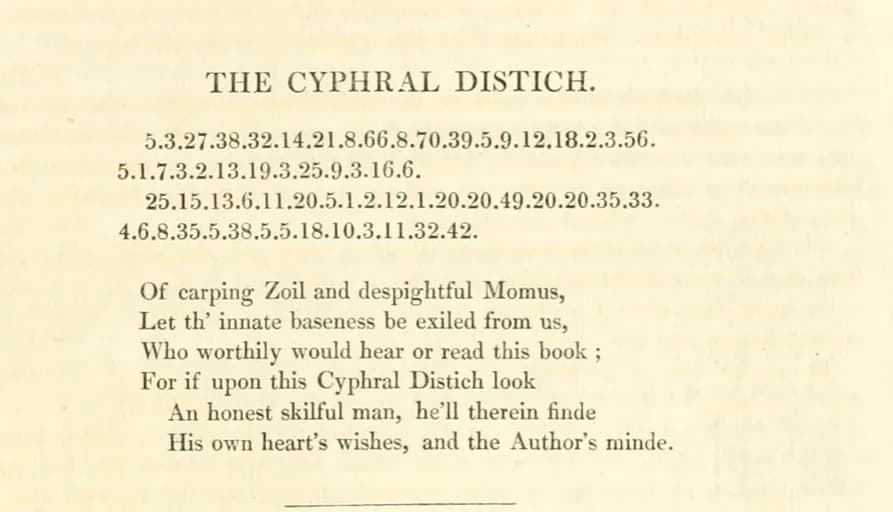
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。