研究突破
ScientistOne:通過證據鏈實現人類水平的自主研究
ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence

arXiv cs.AI · 2026-05-27
摘要
研究團隊推出 ScientistOne 系統與 Chain-of-Evidence(證據鏈)框架,針對自主研究代理在學術論文生成中常見的可驗證性問題,包括虛假引用、不可重現的結果和方法描述與實現不符。該系統通過全程維護證據追蹤鏈,在文獻回顧、方案發現和論文寫作各環節確保研究內容的真實性與可驗證性,並推出 CoE Audit 工具對任何自主研究系統進行完整性檢驗。
研究團隊針對自主研究代理在學術論文生成中常見的不可驗證問題提出解決方案,這些問題包括虛假引用、不可重現的評分結果,以及方法描述與實際實現不符。為應對這些表面評估無法發現的缺陷,團隊推出了 Chain-of-Evidence(CoE)框架,要求每一個論述都必須能追溯至其證據來源。
基於此框架開發的 ScientistOne 系統,是一個端到端的自主研究系統,能在文獻回顧、方案發現和論文寫作的全過程中構建並維護證據鏈。該系統在跨越多個系統與五個前沿研究任務的 75 篇論文測試中,實現了零虛假引用(337 篇中 0 篇)、完美的評分驗證(12/12),以及最高的方法與代碼一致性(14/15),其表現匹配或超越了人類專家在所有五個任務中的水平。
作為對比,所有基線系統在測試中至少存在一種系統性失敗模式:虛假引用率高達 21%,評分驗證通過率低至 42%,而方法與代碼的一致性則在 20% 至 80% 之間波動。此外,團隊推出了 CoE Audit 工具,透過評分驗證、規範違規檢查、參考文獻驗證以及方法與代碼一致性檢查這四項完整性檢驗,對任何自主研究系統進行事後審查。
ScientistOne 進一步在六個額外任務中展現泛化能力,涵蓋醫學影像、細粒度識別、3D 感知和語言建模,並在 Parameter Golf 上達到最優狀態,同時在 MLE-Bench 任務中獲得金牌,而基線系統在這些任務中完全失敗。
●開發者:可採用 Chain-of-Evidence 框架提升研究代理系統的可信度與可審計性
●投資人:自主研究代理領域正逐漸解決可驗證性這一關鍵瓶頸,商用價值提升
●一般用戶:AI 生成的研究論文與數據將更加可靠可追溯
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →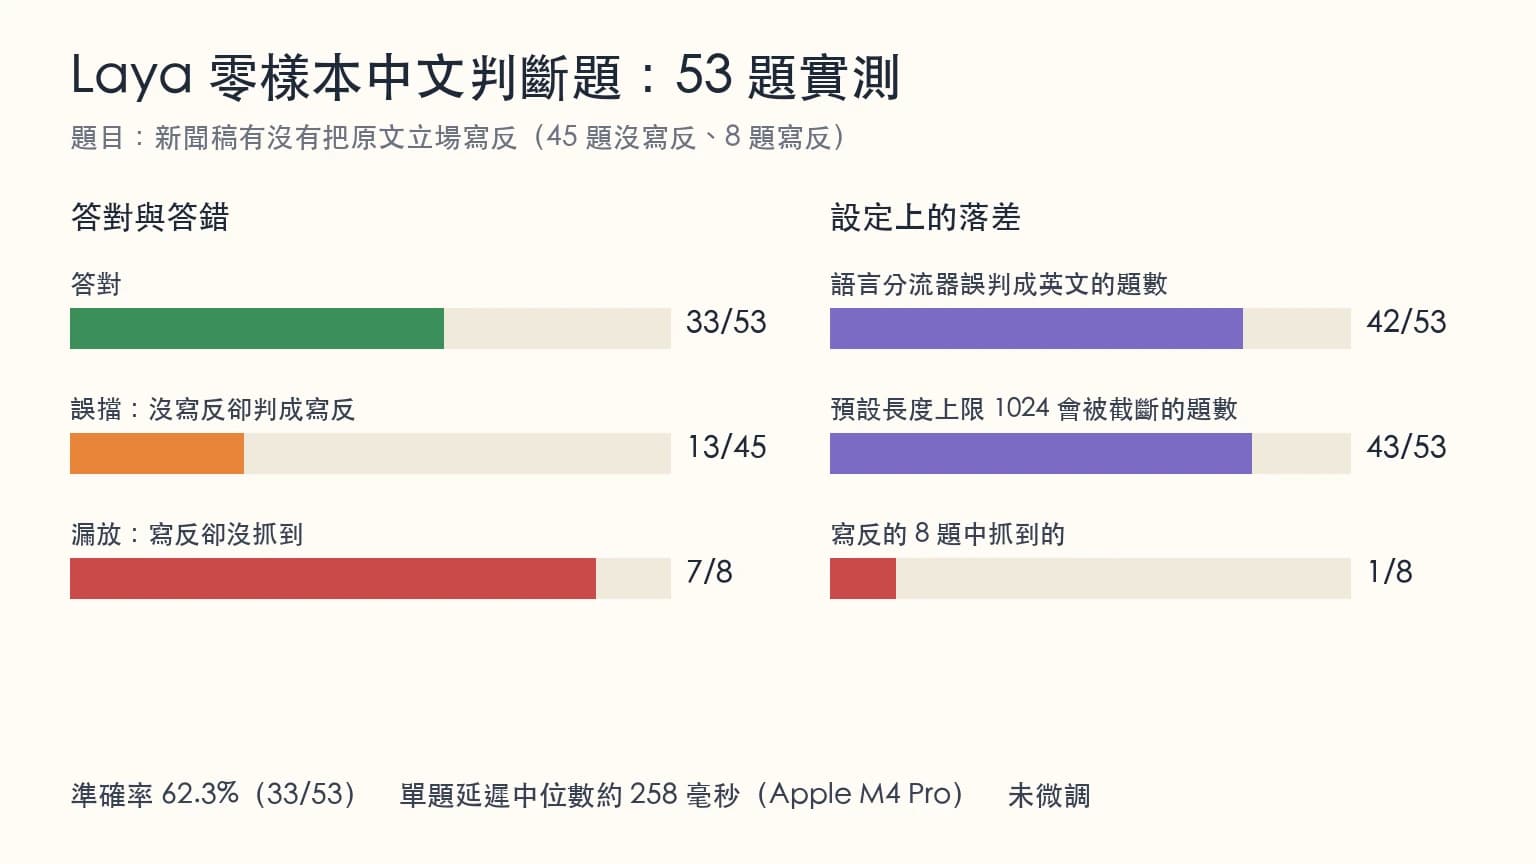
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →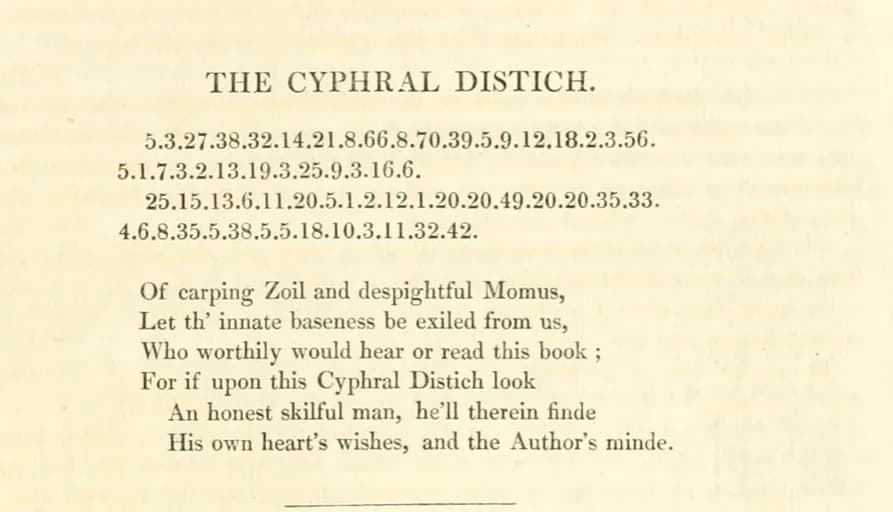
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。