研究突破
歸因盲點:檢測語言模型是否依賴記憶而非檢索上下文
The Attribution Blind Spot: Detecting When Language Models Rely on Memory Rather Than Retrieved Context

arXiv cs.AI · 2026-05-27
摘要
研究團隊發現了 RAG(檢索增強生成)系統的關鍵問題:當檢索到的文檔與模型預訓練數據重疊時,模型可能完全從內部參數記憶中生成文本,卻看起來像是基於檢索內容。論文提出 Computational Reality Monitoring(CRM)方法,通過比較有無上下文的內部表徵來檢測這種「歸因盲點」,這對高風險應用的可信度驗證至關重要。
檢索增強生成(RAG)系統承諾將語言模型的輸出基於外部證據,但該領域目前缺乏可靠方法來驗證檢索到的上下文是否真正主導了生成過程,這成為高風險部署的必要前提。當檢索到的文檔與模型的預訓練數據重疊時,標準假設——即與上下文一致的輸出意味著由上下文主導——會失效。在這種情況下,模型可以完全從參數化記憶中生成看似忠實的文本,而無論是否使用檢索內容,其最終輸出都無法區分。研究團隊將這種失敗命名為「歸因盲點」(attribution blind spot)。
為解決此問題,研究團隊提出了計算現實監控(Computational Reality Monitoring,CRM)方法。CRM 借鑒認知科學中的現實監控框架,通過比較有無上下文時的內部表徵,來檢測成員條件表徵分歧。這種分歧在輸出層級的監控系統中系統性地被遺漏,但 CRM 能揭示其存在。CRM 並不認證單個生成使用了哪個來源,而是檢測預訓練接觸是否留下了可測量的內部軌跡特徵,從而確立源頭歸因的必要基礎。
研究涵蓋了跨越三個家族的多個模型變體,共計九種模型。結果顯示,這種表徵分歧集中在特定架構的層級模式中,並通過區塊級噪聲干預獲得一致性支持。該現象在任務和數據集之間具有通用性,但在領域混淆的基準測試中會消失。歸因盲點是可測量的且部分可解決,內部表徵攜帶了輸出層級無法察覺的診斷信號,這為建立內部意識能主導外部行為的系統奠定了基礎。
●開發者:需要重新審視 RAG 系統的驗證機制,CRM 提供了新的內部表徵監測方案
●投資人:RAG 安全性問題成為主流關注,推高了可靠 AI 基礎設施的需求
●一般用戶:使用 RAG 應用時對生成內容的信任度評估需提高警惕
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

RAG 是什麼?白話文解釋 AI 如何結合搜尋與生成(附實例)
RAG(檢索增強生成)是什麼?用白話文解釋:AI 先去查資料、再根據查到的東西回答,讓答案更準確。本文附實際運作流程圖與實際應用案例,5 分鐘看懂。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →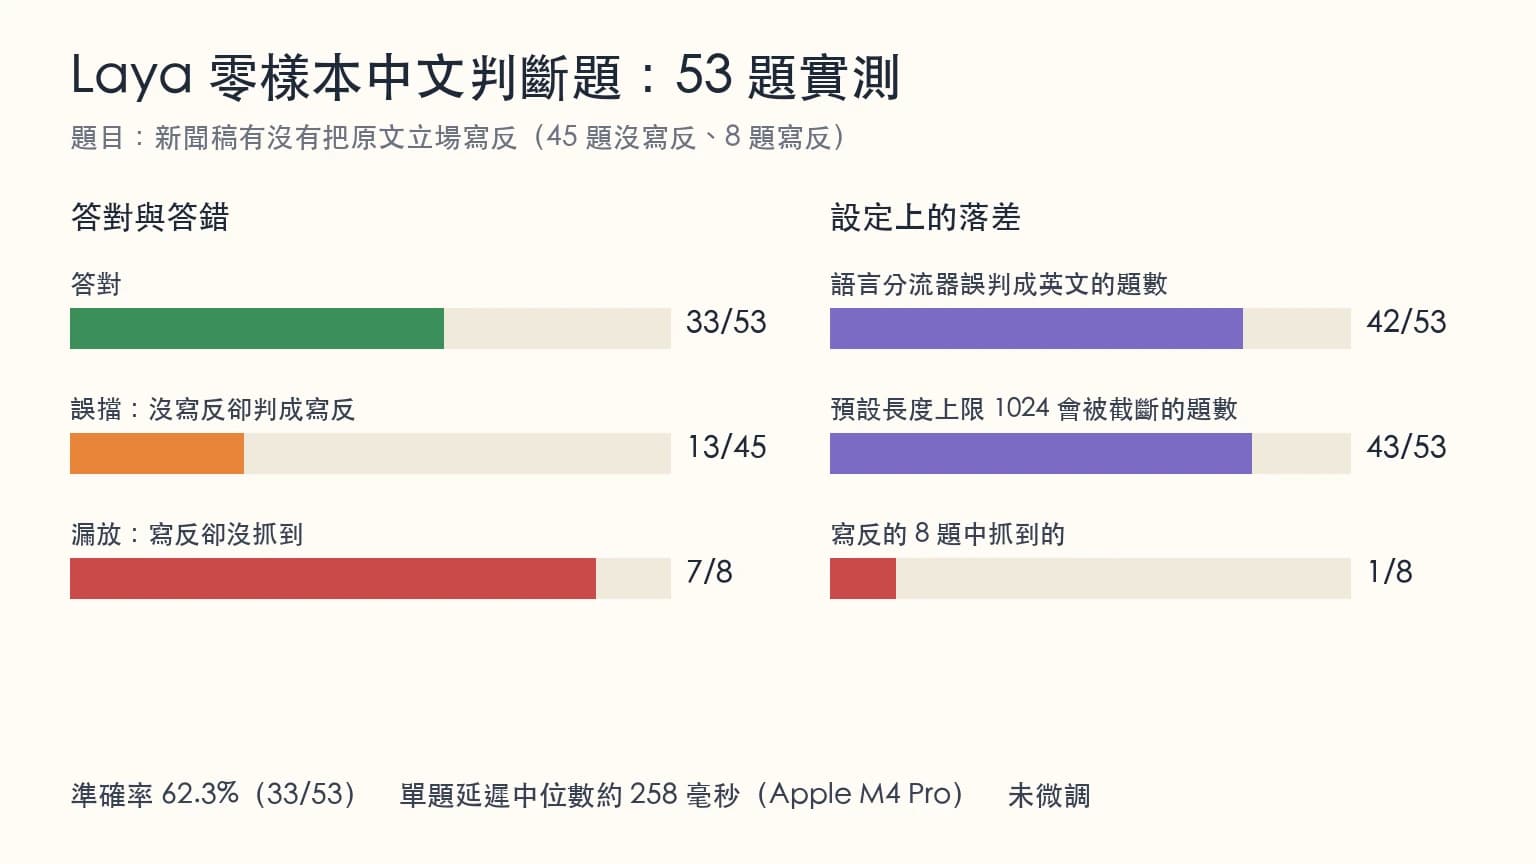
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。